
AIエージェントのためのコンテキストエンジニアリング
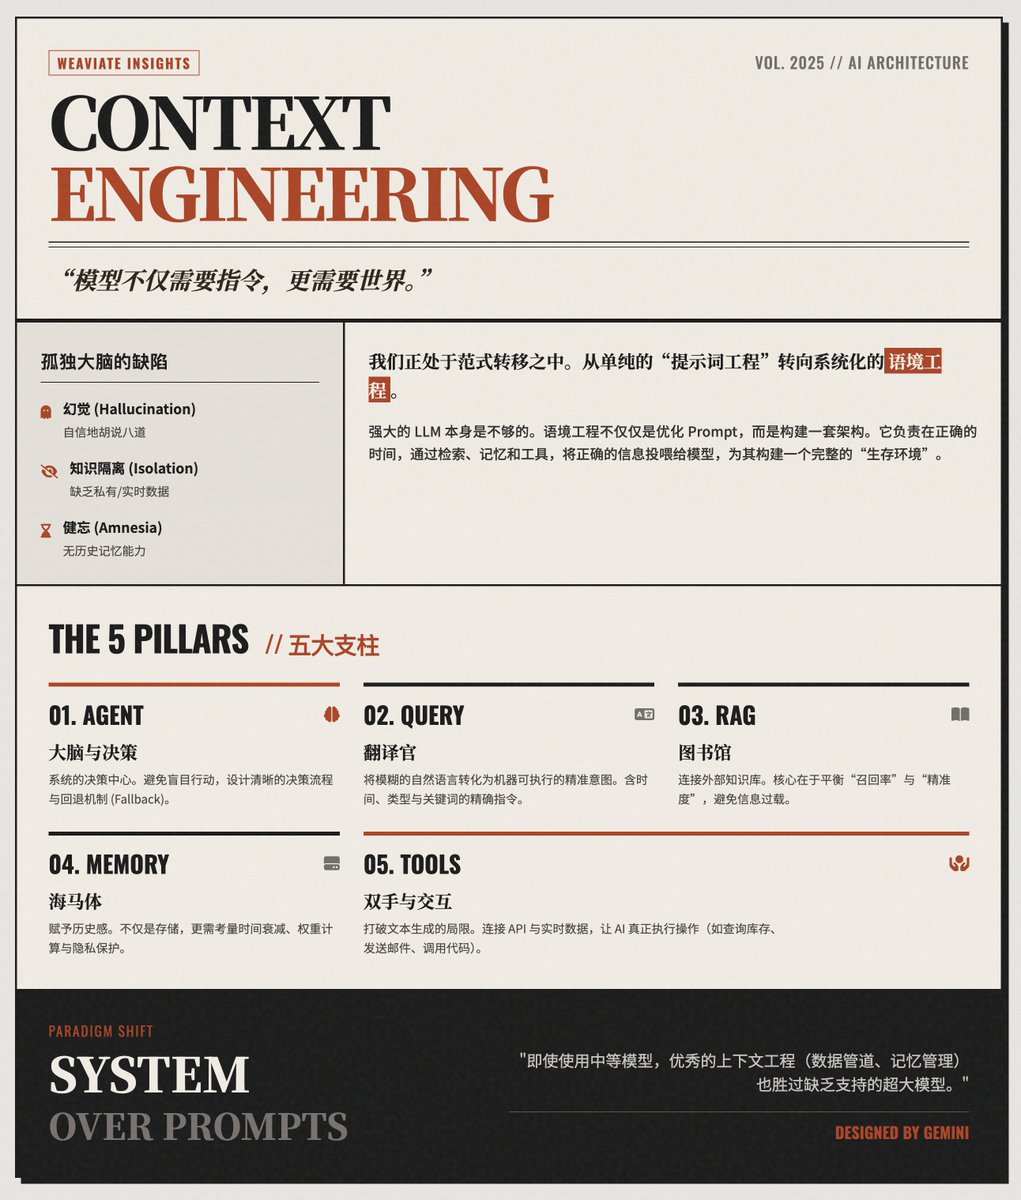
コンテキストエンジニアリングは、モデルの盲目性に対処し、LLMを現実世界に接続します。
Key insights
コンテキストエンジニアリングはLLMを現実世界に接続するために必要である
コンテキストエンジニアリングは、LLMの三つの固有の欠陥、すなわち幻覚、知識の孤立(プライベートまたはリアルタイムデータの欠如)、持続的メモリの不在に対するシステムレベルの解決策として提示されています。このアプローチは、モデルの決定時に正しい外部情報を供給することを強調し、単にモデルの容量を大きくすることに依存するのではなく、検索、メモリ、ツールを含むエンジニアリングされたコンテキストを必要なインフラストラクチャとして位置付けています。
生産コンテキストエンジニアリングを定義する五つのアーキテクチャの柱
この記事では、生産AIアプリケーションのための五つのコアパターンを列挙しています:エージェント(定義されたフローとフォールバックを持つ意思決定センター)、クエリ拡張(曖昧な自然言語を正確な検索/実行意図に変換する、例えば時間/タイプ/キーワードを追加する)、検索(リコールと精度のトレードオフを持つ知識ストアへの接続)、メモリ(時間の経過と重要性の重み付け、プライバシー管理を伴う歴史的コンテキスト)、およびツール(エージェントがテキスト生成を超えた操作を実行できるAPIとアクション)。各柱には具体的な責任と制約があります。
コンテキストエンジニアリングはシステムパフォーマンスのために生のモデルスケールを上回る
この投稿は、古いプロンプトエンジニアリングアプローチと現代のコンテキストエンジニアリングを対比させています。データパイプライン、検索品質、メモリ管理に投資することは、単に大きなモデルを使用するよりも、しばしばより良いシステムの成果をもたらします。推奨されるのは、エンドツーエンドのコンテキスト配信を設計することであり、これにより中規模モデルでもコンテキスト統合が欠如した大型モデルを上回ることができます。これは、プロンプトの言い回しからアーキテクチャ(データフロー、リトリーバー、メモリポリシー、ツール統合)への努力の再構築を促します。
バックプレッシャーと決定論的フィルタリングがコーディングエージェントのトークン浪費を削減する
別の分析では、冗長なツール出力(例えば、テストログ)からのトークン浪費を削減するために、ツールレベルの決定論的制御を推奨しています。このパターンは、デフォルトの出力を飲み込み、テストが成功した場合には簡潔な成功マーカー(✓とラベル)を発信し、失敗時のみ完全なログを転送するラッパーです。追加の戦術には、クイックフェイルフラグ(最初の失敗で停止)、失敗したアサーションのみを抽出、スタックトレース/タイムスタンプの削除、盲目的な切り捨てを避けることが含まれます。このガイダンスは、無関係なトークンを無視するためにモデルのヒューリスティックに依存するのではなく、ツールチェーンのノイズ削減を強調しています。