
AIエージェントの自己進化:WikiSkillとLoopArenaベンチマーク
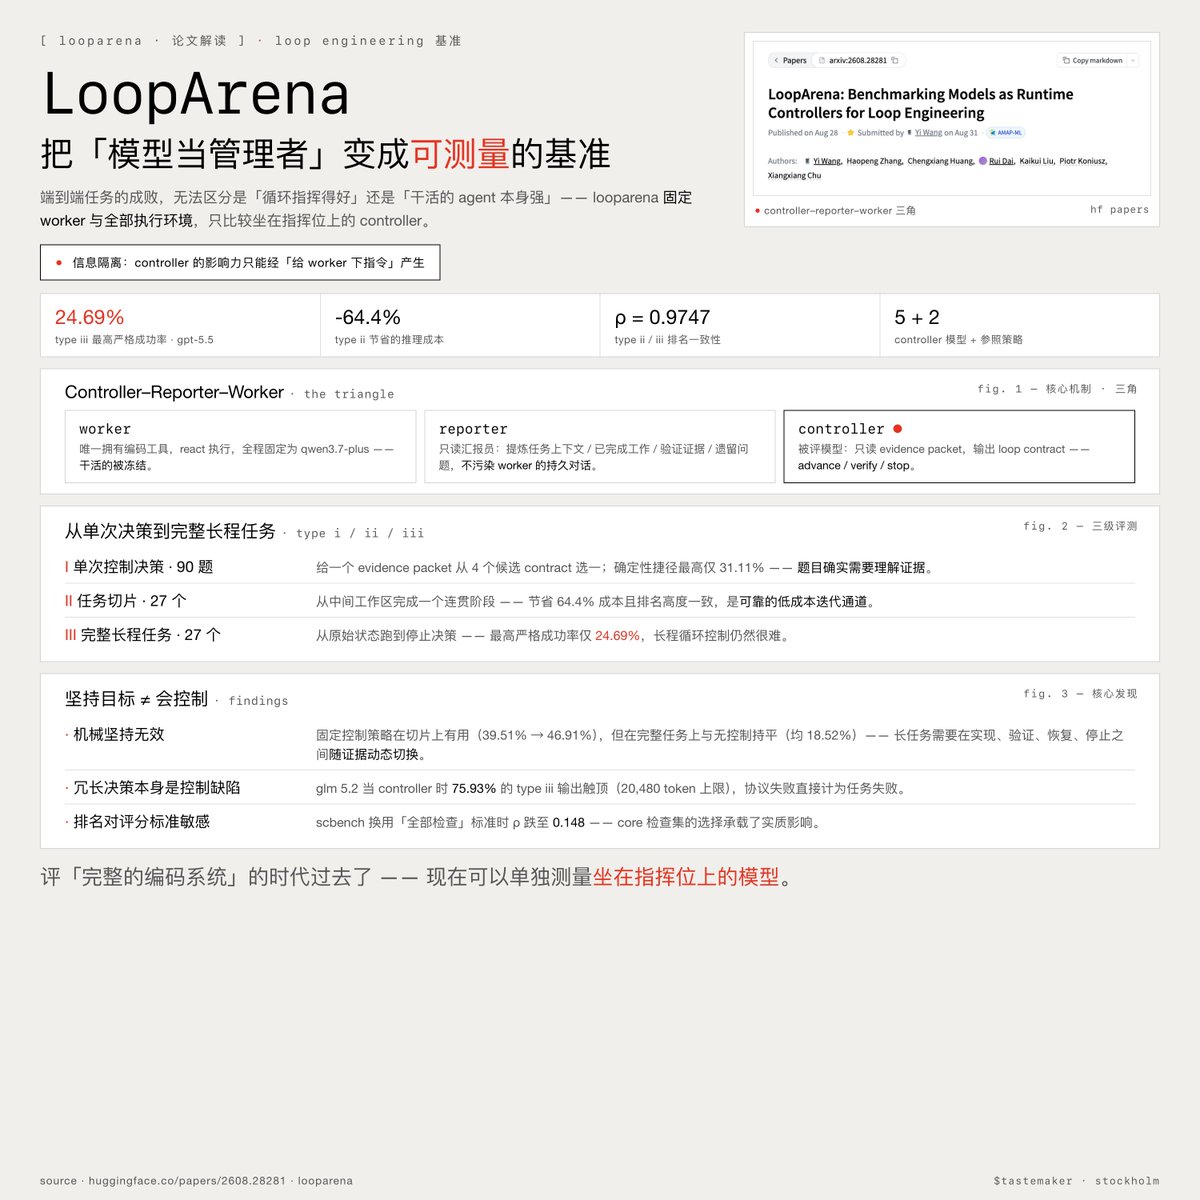
Google Researchは、AIエージェントがタスク実行の経験を永続的なWikipediaのような知識ベースに蓄積し、より強力な実行可能スキルへと進化させるフレームワーク「WikiSkill」を提案した。このフレームワークは、エージェントが個々のタスクから学習し、断片的な経験を再利用可能な能力に統合する方法を研究する。別途、LoopArenaは、すべてのテストでワーカーモデルを単一モデルに固定し、コントローラモデルの実行時意思決定のみを評価することで、コントローラモデルの能力とワーカーの実行品質を分離するベンチマークを導入した。結果は、長距離エージェント制御が依然として困難であり、GPT-5.5でもフル長タスクでの厳格成功率は24.69%にとどまった。一方、タイプIIタスクスライスでは、フルタスクとの高い順位相関を維持しながら、平均推論コストを64.4%削減できることが示された。
Key insights
エージェントのスキル蓄積にはモデル重みを超えた明示的な知識永続化メカニズムが必要
WikiSkillは、エージェントがタスクを正常に完了することと、その経験を将来のタスクに保持することの間のギャップに対処する。このフレームワークは、経験的な教訓が一時的なコンテキストではなく構造化された実行可能スキルとなる、Wikipediaに類似した永続的な知識ベースを作成する。これは、各エージェントタスクを独立したものとして扱うのではなく、明示的な知識抽出と保存メカニズムを通じて累積的な能力を構築する方向への転換を意味する。
現在の最先端モデルは単一ステップ推論に強いが長距離エージェント制御では低パフォーマンス
LoopArenaの結果は、最良のコントローラモデルでもフル長コーディングタスクでの厳格成功率が24.69%にとどまり、テストされたすべてのコントローラは16.05%から24.69%の範囲であった。このベンチマークは、ワーカーモデルを固定することでコントローラの品質を分離し、システムレベルの交絡を排除する設計となっている。GLM 5.2はタイプIII評価の75.93%で出力の切り詰めを示し、冗長な意思決定自体が制御の欠陥であることを示唆している。固定制御戦略はタイプIIのパフォーマンスを向上させたが、タイプIIIタスクでは無制御と同一の結果であり、実装、検証、回復、停止の間で動的な証拠に基づく切り替えを必要とするフルタスクでは、機械的な目標の繰り返しが機能しないことが証明された。