
AIコーディングエージェントの進展とベンチマーク
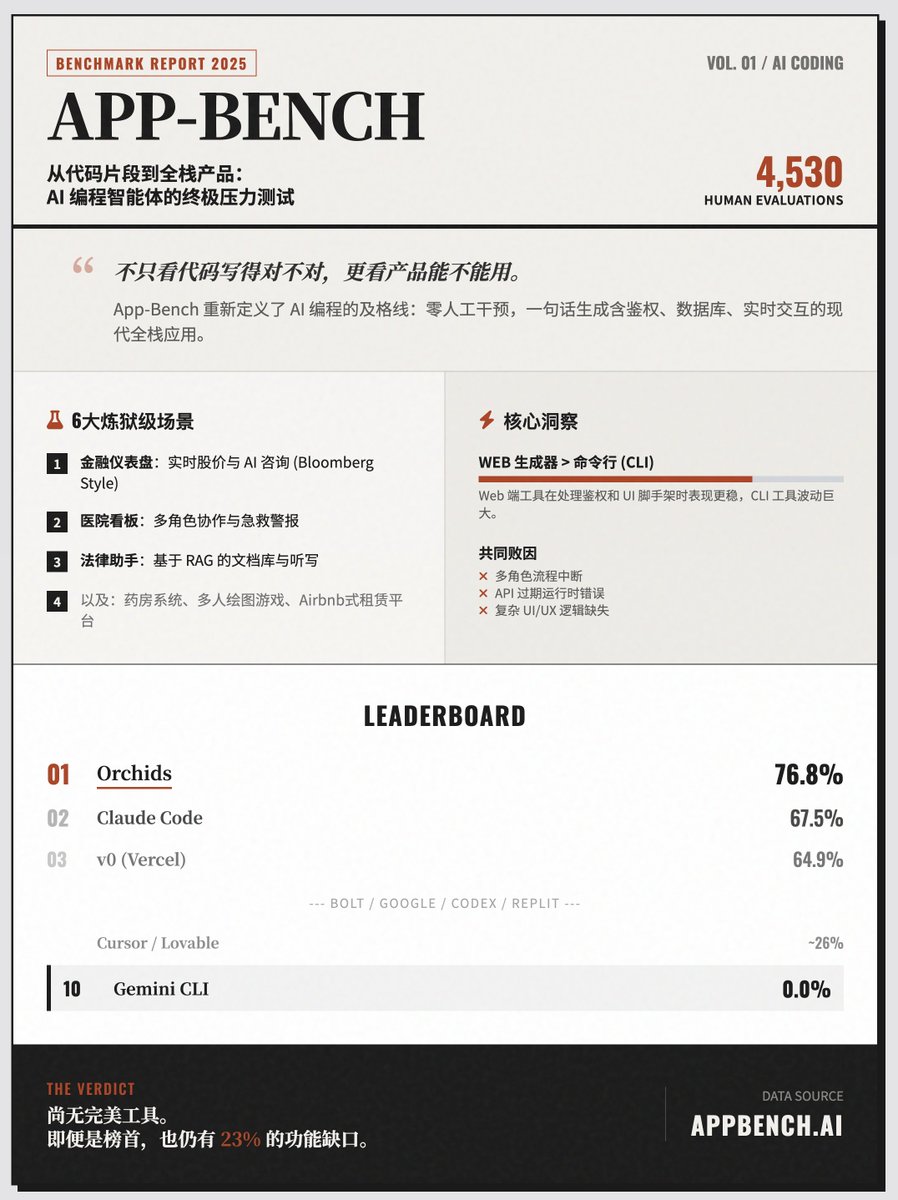
ベンチマーキングと進化的コーディングエージェントがエンドツーエンドの開発者自動化をテストします。 - App-Benchはゼロ人間によるフルスタックアプリ生成を評価します。 - 六つのシナリオ:ファイナンスダッシュボード、病院管理ボード、法務アシスタント、薬局、ピクショナリー、レンタルプラットフォーム - スコアリング:151の基準、4,530の手動評価、各ツールにつき三回の試行 - トップランク:Orchids 76.8%、Claude Code 67.5%、v0 64.9%、Gemini CLI 0.0% - 最良のツールは依然として必要な機能の約77%をカバー - 主な失敗:マルチロールフロー、APIの期限切れ、UI/UXおよび欠落機能 - ウェブジェネレーターはCLIよりも安定性と認証/UIで優れています。 - AlphaEvolve = Gemini + Evolution; Googleがプライベートベータを発表 - AlphaEvolveは進化的検索を実行します:問題仕様 + 評価者 + シードプログラム - 内部の利益:データセンターの計算能力が約0.7%回復、カーネルの速度が23%向上、全体のトレーニング時間が1%減少 - AlphaEvolveはコーディング最適化のためのサービスAPIとして提供されます。
Key insights
App-Benchはゼロ人間によるフルスタックアプリ生成を評価
App-Benchは、AIエージェントが単一の自然言語プロンプトから完全で使用可能な現代のウェブアプリケーションを生成できるかどうかをテストする高難度のベンチマークです。これは、金融ダッシュボード、病院管理ボード、RAGを用いた法務アシスタント、薬局システム、マルチプレイヤーピクショナリー風ゲーム、レンタル予約プラットフォームという六つの複雑な実世界シナリオを使用しています。スコアリングは、151の基準に基づくシニアフルスタック開発者による手動評価に依存し、合計4,530の評価が行われました。各ツールは三回の試行を受け、最高スコアが記録されました。
ベンチマーク結果は能力のギャップとランキングの詳細を示す
App-Benchの結果は、Orchidsが76.8%で1位、Claude Codeが67.5%で2位、v0(Vercel)が64.9%で3位、Gemini CLIが0.0%という結果でした。トップツールでさえ、必要な機能の約77%しか達成できませんでした。一般的な失敗モードには、マルチロールワークフローの欠如、期限切れまたは壊れたAPIによるランタイムエラー、使いやすさに影響を与えるUI/UXの問題が含まれました。ウェブベースのジェネレーターは、認証と基盤となるUIロジックの処理において高い変動を示したCLIツールよりも、平均的にわずかに優れたパフォーマンスを示しました。
AlphaEvolveはアルゴリズム設計を進化的検索に変える
AlphaEvolveは、Gemini + Evolutionとして説明される進化ベースのコーディングエージェントで、問題仕様、目的評価者、シードプログラムを受け入れ、その後、Geminiモデルと自動評価者によって駆動される変異と選択を通じてコードのバリアントを進化させます。GoogleはAlphaEvolveがプライベートベータにあることを発表し、内部の利益を報告しました:スケジューリングにおいて約0.7%のグローバルデータセンター計算能力が回復し、トレーニングパフォーマンスを改善する重要なカーネルで23%の速度向上、全体のトレーニング時間で1%の削減がありました。このサービスは外部利用のためにAPIを介して提供されています。
ベンチマーク設計と失敗分析はエンドツーエンドのギャップを強調
App-Benchの方法論—複雑なシナリオ、手動スコアリング、各ツールにつき複数の試行—は、現在のコーディングエージェントがコードの断片を書くことはできるが、エンドツーエンドの製品要件、すなわちマルチユーザーロール、リアルタイム同期、認証フロー、生産品質のUI/UXに苦労していることを浮き彫りにしています。このベンチマークの手動で基準が豊富なスコアリングは、実装と統合の問題が主な短所であることを明らかにし、単なるコードの正確性にとどまらないことを示唆しています。これは、現在のエージェントが生産準備を整えるために、より強力なシステム統合、ランタイム検証、および更新処理を必要としていることを示唆しています。