
AnthropicとClaude:エージェント評価、ハーネス設計と戦略
Anthropicおよび関連する投稿は、ハーネス設計、エージェント評価、政策インタビューについて説明しました。
Key insights
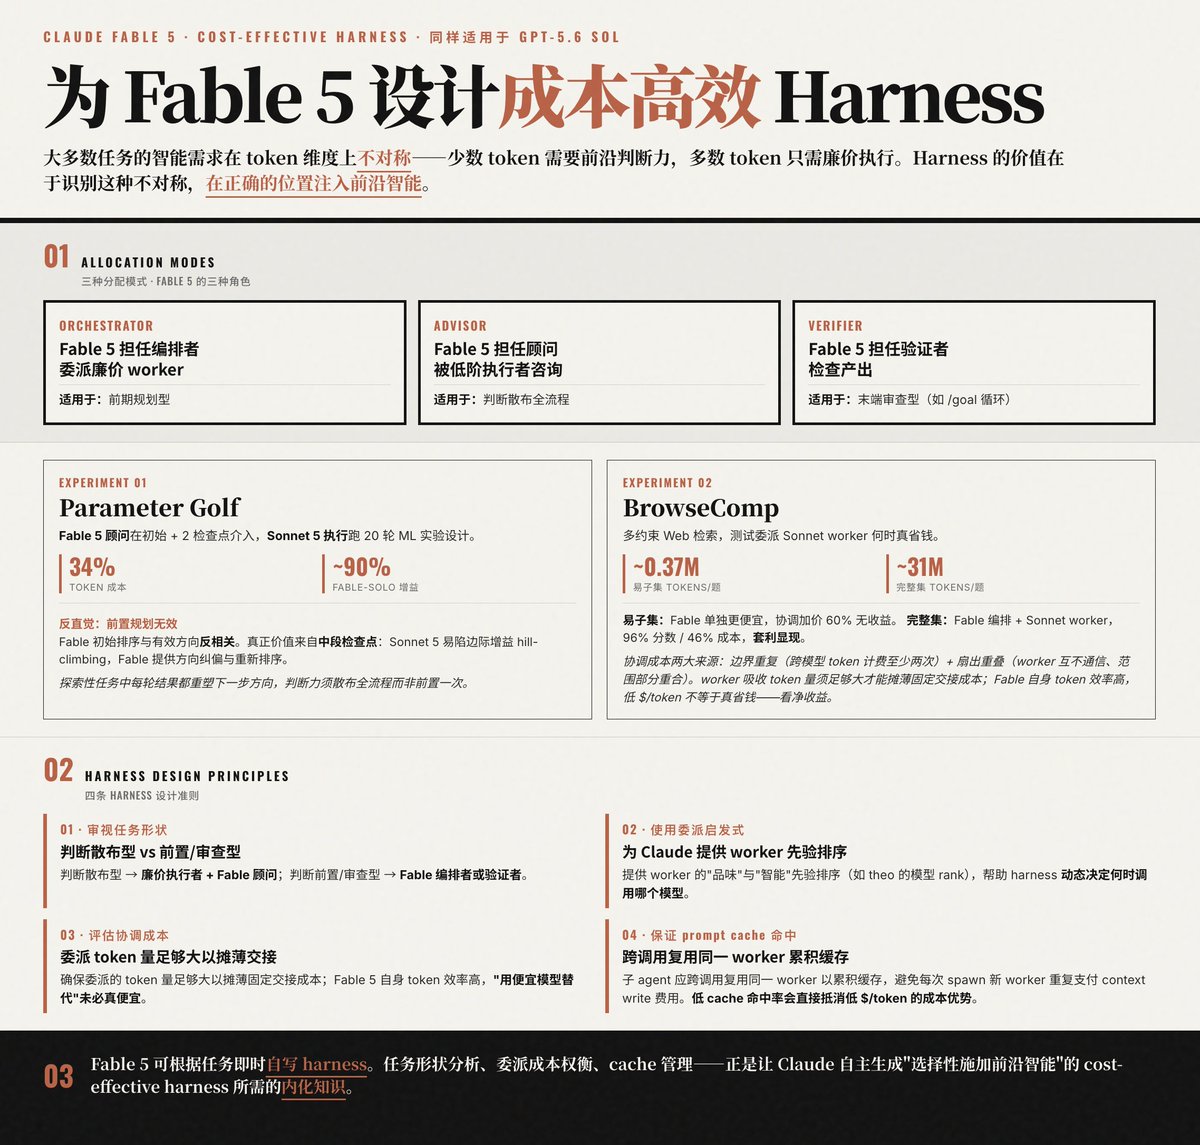
コスト効率の良いハーネスがトークン配分を最適化
Anthropicは、判断ポイントに高コストのフロンティアモデルを配置し、大部分のトークン作業を安価なワーカーに委任する3つのハーネスパターン—オーケストレーター、アドバイザー、バリファイア—を説明しました。実験では、Parameter GolfにおいてFable-as-advisorとSonnetエグゼキューターの組み合わせが、約34%のトークンコストでFable単独のパフォーマンスの約90%に達することが示されました。また、BrowseCompでは、オーケストレーターとワーカーの組み合わせが大規模な情報取得タスクにおいて96%のスコアを維持しながらコストを46%削減しました。設計ルールには、タスク形状の分析、委任ヒューリスティクス、調整コストの評価、プロンプトキャッシュの最適化が含まれます。
Anthropicが運用エージェント評価フレームワークを提供
Anthropicは、評価をタスク、グレーダー、トランスクリプト、ハーネスの層に構造化するエージェント評価手法を発表しました。可能な限り決定論的スコアリングを規定し、非決定論を捉えるためにpass@kおよびpass^kを使用し、トランスクリプション監査を行い、手動テストから安定したCI/CD評価への8ステップの実装パスを示しています。Anthropicは、自動テスト、プロダクションモニタリング、A/Bテスト、人的レビューを組み合わせて盲点を避けることを強調しています。
Anthropicのリーダーシップが楽観主義と安全性の警戒を強調
ダボスでのインタビューで、AnthropicのCEOダリオ・アモデイは、モデル能力の成長を指数関数的で差し迫ったものとし、大規模な経済的混乱(雇用の喪失を含む)を警告し、中国への特定のチップ輸出政策に反対し、欺瞞的または機能的に有害なモデルの振る舞いを検出するための機械的解釈可能性と極端なストレステストのアプローチを説明しました。Anthropicは、内部使用指数を使用して自動化と拡張の効果を定量化しています。
評価はエージェントの複雑性と非決定論を反映する必要がある
Anthropicは、エージェントシステムの多段階、ツール使用、状態保持の振る舞いには層状の評価が必要であると主張しました:決定論的なプログラムチェック(例:コード実行)、シミュレートされたユーザーインタラクション、サンドボックス化されたツール使用の記録、事後トランスクリプト監査が含まれます。pass@kおよびpass^kのようなメトリクスは、単一実行の信頼性と複数回の試行における少なくとも1回の成功を捉えるために推奨され、評価ハーネスは環境ノイズや繰り返し実行に対して堅牢でなければなりません。