
Artificial Analysis Coding Agent Index v2.1:Claude Fable 5.2とOpus 5.5が58で首位タイ
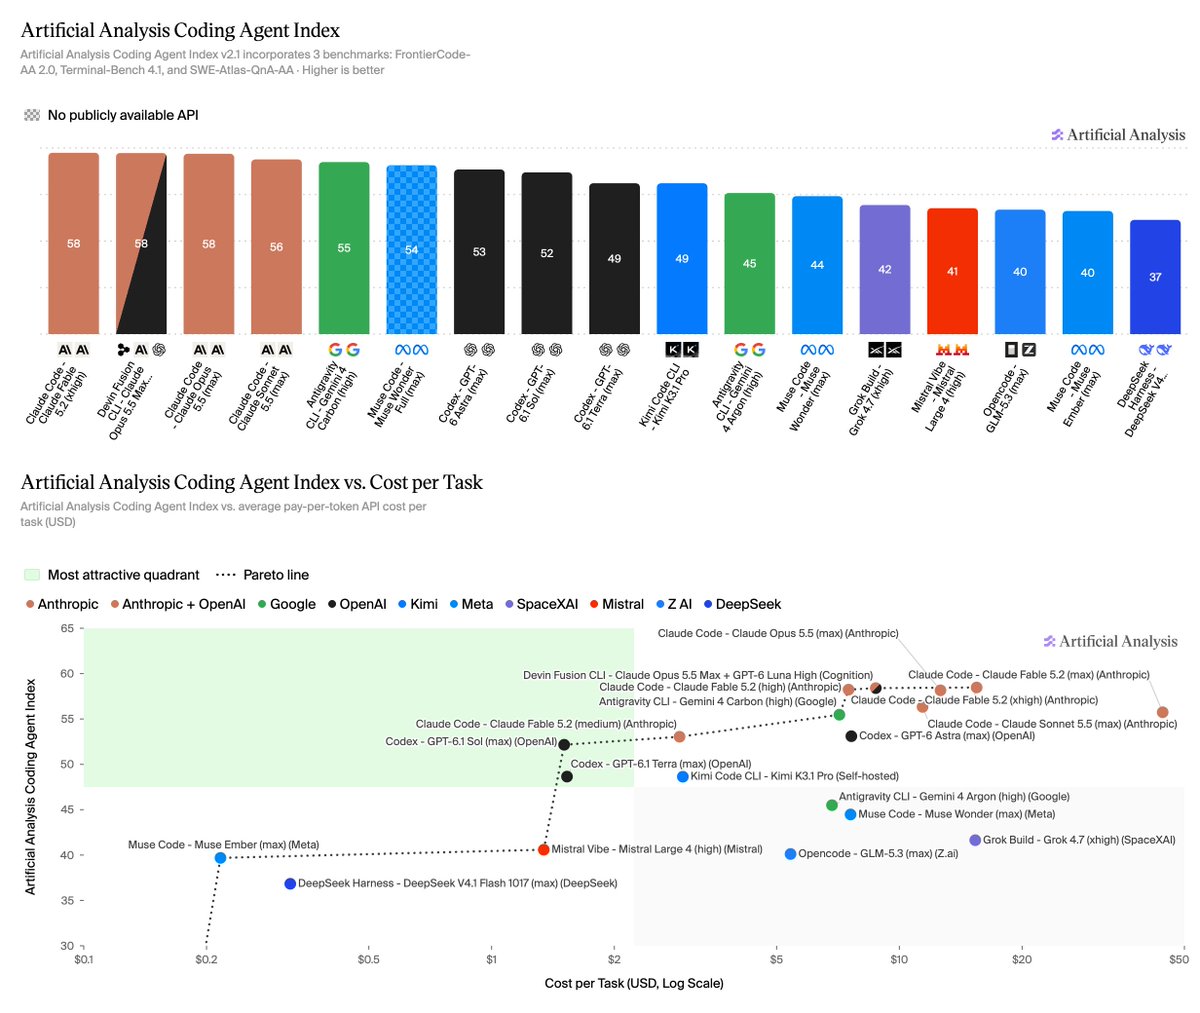
Artificial AnalysisはCoding Agent Index v2.1をリリースし、FrontierCodeを2.0に、Terminal-Benchを4.1にアップグレードした。Claude Fable 5.2とClaude Opus 5.5が58で首位を分け合う一方、FrontierCode-AA 2.0へのアップグレードによりインデックススコアは平均5ポイント低下した。スコア48以上の構成におけるタスクあたりのコストは1.51ドルから44.22ドルの範囲である。
イベントのバージョン 1.
Key insights
首位タイ
Claude Fable 5.2はClaude Codeにおいてxhighとhigh effortの両方で58を記録。Claude Opus 5.5(max)はClaude Codeで58、さらにGPT-6 Luna Highと組み合わせたCognitionのDevin Fusion CLIでも58を記録した。
インデックス構成要素のアップグレード
FrontierCode-AA 2.0はFrontierCode v1.1を置き換え、リポジトリのメンテナーが変更をマージするかどうかで採点される132の実世界コーディングタスクを採用。Terminal-Bench 4.1は同じ66タスクを維持しつつ、信頼性と報酬ハッキング耐性のために検証器を更新した。
v2.1でスコアが低下
v2.1ではFrontierCode-AA 2.0へのアップグレードに起因してインデックススコアが低下し、モデルは平均5ポイント低いスコアとなった。Codex with GPT-6.1 Terra(max)はバージョン間でスコアが低下しなかった唯一の構成であり、以前のスコアから1ポイント以内に留まった。
上位構成間のコスト差
スコア48以上の構成ではタスクあたりのコストが約30倍の幅で変動し、Codex with GPT-6.1 Sol(max、52)の1.51ドルからClaude Code with Claude Fable 5.2(max、56)の44.22ドルに及ぶ。
その他の主要構成
Claude Fable 5.2(max)はタスクの時間制限に達する試行が増えたため56を記録。Claude CodeのClaude Sonnet 5.5(max、56)とAntigravity CLIのGemini 4 Carbon(high、55)が続く。