
Artificial Analysis、プライベートデータセットを採用したIntelligence Index v5を発表
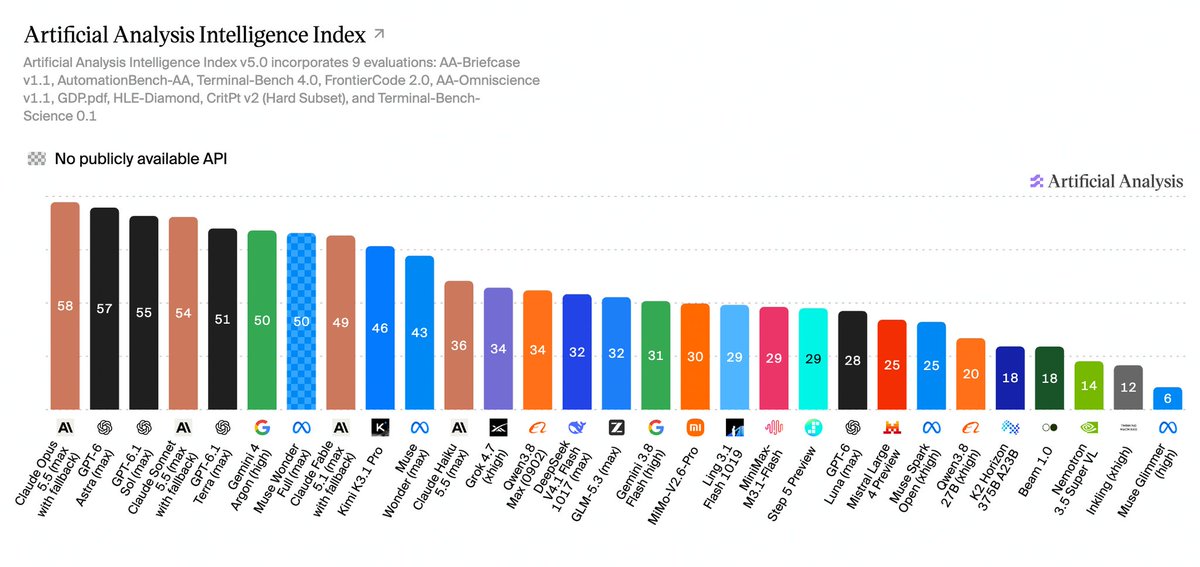
Artificial Analysisは、v4以来最大のアップグレードとなるIntelligence Index v5を発表した。Indexの60%がプライベートテストセットまたは保留回答に基づくようになった。今回のリリースではFrontierCode 2.0とTerminal-Bench-Scienceが追加され、HLE-Diamond、AA-Omniscience v1.1、CritPt v2がアップグレードされ、Progress Index v1が導入された。Claude Opus 5.5が58で首位に立ち、オープンウェイトのギャップは3ポイントから12ポイントに拡大した。
イベントのバージョン 1.
Key insights
プライベートデータセットが過半数に
v5では、Intelligence Indexの60%がプライベートテストセットまたは保留回答を用いた評価に基づいており、Indexの過半数がプライベートデータセットで構成されるのは初めてである。
新規およびアップグレードされたベンチマーク
FrontierCode 2.0とTerminal-Bench-ScienceがIndexに加わり、HLE-DiamondがHumanity's Last Examに代わって採用され、AA-Omniscience v1.1が更新され、CritPt v2はコード実行ツールを用いて実行されるプライベートな40問のサブセットとなった。
トップモデルのランキング
Claude Opus 5.5(max)が58で首位に立ち、GPT-6 Astra(max、57)とGPT-6.1 Sol(max、55)が続く。AnthropicとOpenAIがトップ5モデルを占め、Gemini 4 Argon(high)が50で次に位置する。
オープンウェイトのギャップ拡大
オープンウェイトのギャップは3ポイントから12ポイントに拡大した。Kimi K3.1 Pro(ウェイト未公開)が46でオープンウェイトモデルの首位となり、公開済みウェイトのリーダーであるDeepSeek V4.1 Flash 1017(max)とGLM-5.3(max)は32である。
タスクあたりのコストのばらつき
主要モデル間でタスクあたりのコストは13倍以上異なり、GPT-6.1 Terra(max)のIntelligence Indexタスクあたり0.96ドルからClaude Fable 5.1(max)の13.04ドルに及ぶ。