
Artificial AnalysisがCoding Agent Index v2.0を公開、Claude Opus 5.5が61.7で首位
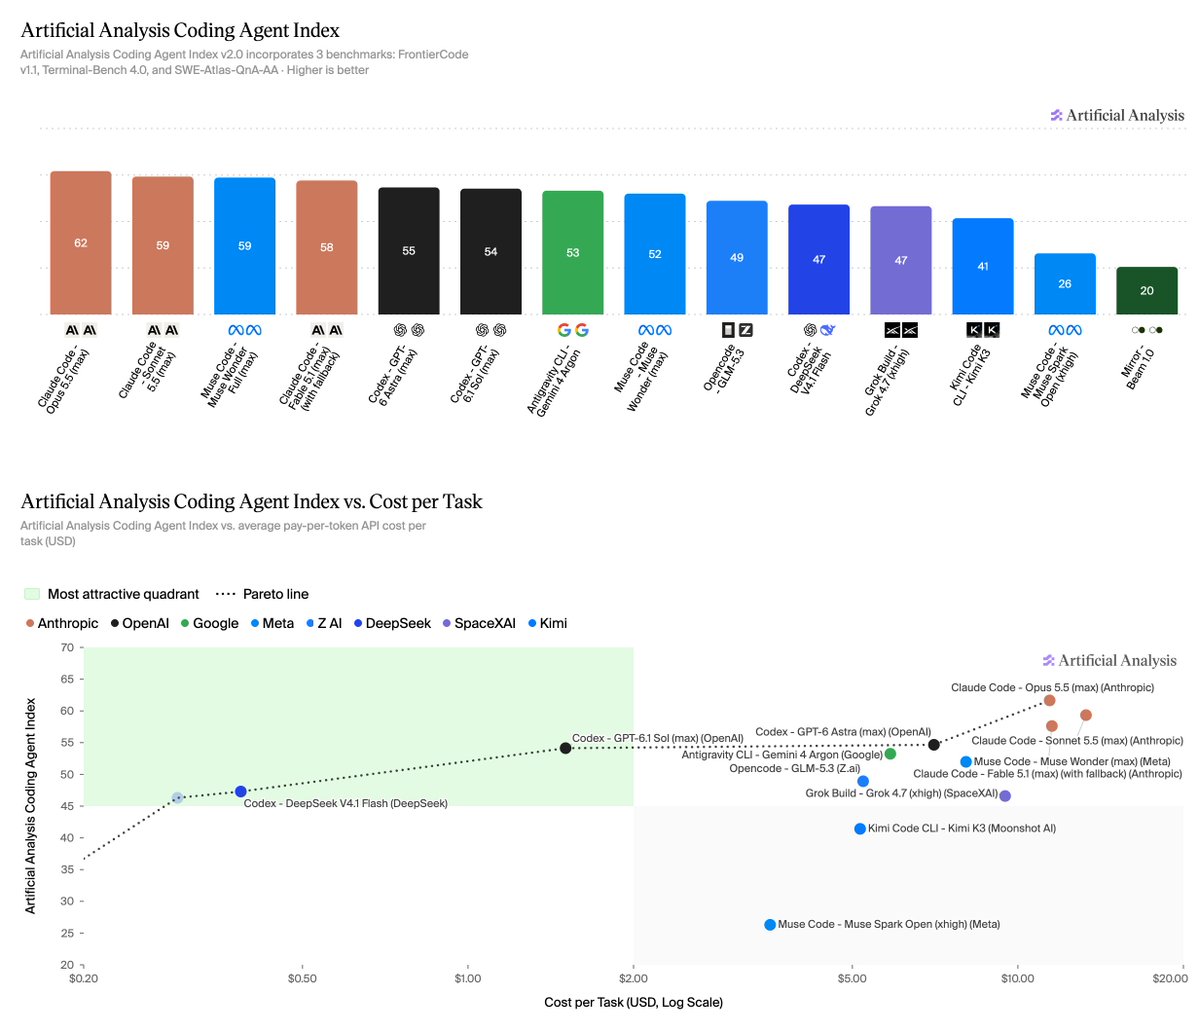
Artificial AnalysisはCoding Agent Index v2.0をリリースし、DeepSWEをCognitionのFrontierCode v1.1に置き換え、SWE-Atlas-QnAの採点を改訂した。インデックスは現在、均等に重み付けされた3つのベンチマークにわたる290タスクをカバーし、Claude Opus 5.5を実行するClaude Codeが61.7で首位に立つ。
イベントのバージョン 1.
Key insights
Claude Opus 5.5がインデックス首位
Claude Opus 5.5(max)を搭載したClaude Codeが61.7で首位、続いてClaude Sonnet 5.5(max)を搭載したClaude Codeが59.3、Muse Wonder Full(max)を搭載したMuse Codeが58.9となった。上位4構成のうち3つがClaude Codeを使用している。
FrontierCode v1.1がDeepSWEを置き換え
CognitionのFrontierCode v1.1は、実際のオープンソースリポジトリ上の100のソフトウェアエンジニアリングタスクを含み、非公開のテストセットを備え、メンテナが変更をマージするかどうかで採点される。解答資料へのアクセスがフラグされた試行は0点となる。
SWE-Atlas-QnAの採点を改訂
SWE-Atlas-QnA-AAはScale AIの124リポジトリのQ&Aタスクを維持するが、1,306のルーブリック基準のうち127を言い換え、GPT-6 Luna(xhigh)を審査員として使用し、各基準につき5票を投じる。21構成の平均スコアは58.8%から57.1%へ1.7ポイント低下した。
インデックススコアはv1.5比で低下
両バージョンで評価された21構成全体で、平均インデックススコアは54.8から47.4へ移動し、21のうち20が低下した。この変化は主にFrontierCode v1.1によるもので、構成の平均はDeepSWE v1.1の65.6%に対して45.1%となった。
コストフロンティア上の4構成
DeepSeek V4.1 Flash(max)を搭載したCodexはタスクあたり$0.39で47.3、GPT-6.1 Sol(max)を搭載したCodexは$1.50で54.1、GPT-6 Astra(max)を搭載したCodexは$7.04で54.7、Claude Opus 5.5(max)を搭載したClaude Codeは$11.42で61.7となった。コストはトークン単位の従量制APIコストである。