
Artificial Analysisがプライベートベンチマークとキャリブレーション指標を備えたDecision Index v2をリリース
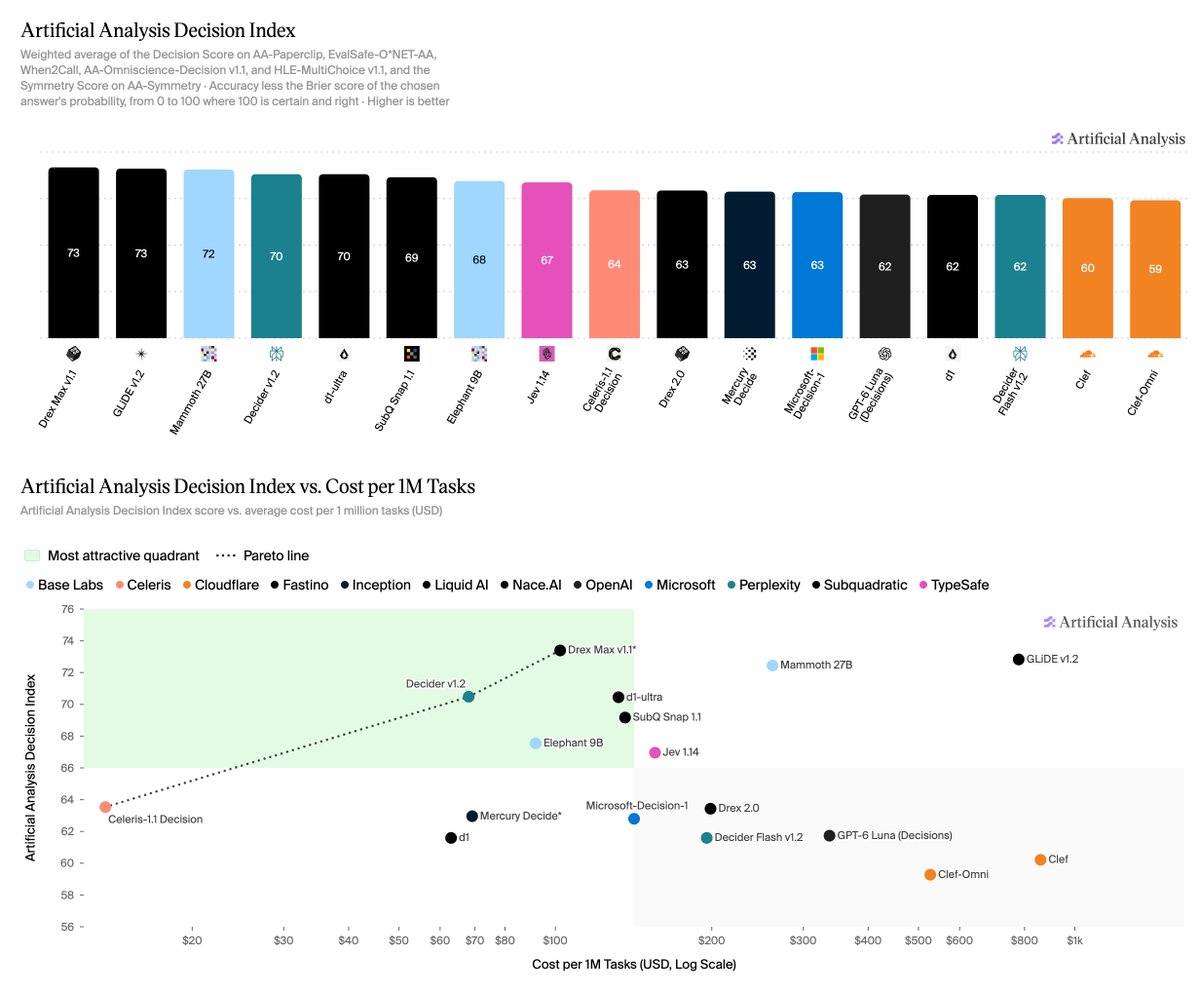
Artificial AnalysisはDecision Indexの第2版をリリースし、プライベートデータセットをインデックスの45%に引き上げ、正確性とキャリブレーションされた信頼度の両方を評価するDecision Scoreを導入した。Nace AIのDrex Max v1.1とFastino LabsのGLiDE v1.2はともに73点、Base LabsのMammoth 27Bは72点である一方、Claude Haiku 5.5(Max)は77点、GPT-6 Luna(Max)は76点を記録したが、コストとレイテンシは大幅に高い。
イベントのバージョン 1.
Key insights
プライベートデータの割合が45%に上昇
Decision Index v2はインデックスの45%をプライベートデータセットで構築しており、v1の25%から増加している。新しいAA-Paperclipベンチマークは、履歴書、領収書、請求書、AIおよび機械学習の研究論文を含む1,500の文書を対象とし、モデルは文書ごとに15の回答すべてが正しい場合にのみ正解と採点される。
Decision Scoreはキャリブレーションされた信頼度を評価
新しい主要指標は各質問を0から100で採点し、正解は50以上、不正解は50未満となり、トップ回答への信頼度が各半分の範囲内でスコアを変動させる。AA-Symmetryは、選択肢の並べ替え、ラベルの交換、否定形のはい/いいえ変形を含む120の質問で確率の一貫性を測定する。
トップ決定モデルは1ポイント以内に集中
Nace AIのDrex Max v1.1とFastino LabsのGLiDE v1.2はともに73点、Base LabsのMammoth 27Bは72点である。Celeris-1.1 Decision、Decider v1.2、Drex Max v1.1はDecision Index対コストのパレートフロンティア上に位置する。
100万タスクあたりのコストは60倍以上変動
Celeris-1.1 Decisionは100万タスクあたり14ドル、Decider v1.2は68ドル、Drex Max v1.1は102ドル、Clefは859ドルである。GLiDE v1.2は780ドルで、Drex Max v1.1の約8倍高い。これは文書の入力を質問ごとに請求し、一度だけ請求しないためである。
言語モデルはより高いコストとレイテンシで高スコアを記録
Claude Haiku 5.5(Max)はDecision Index v2で77点、GPT-6 Luna(Max)は76点を記録し、Drex Max v1.1を約3ポイント上回る。GPT-6 Luna(Max)は100万タスクあたり1,530ドルでDrex Max v1.1の102ドルに対して高コストであり、タスクあたり11.34秒を要するのに対しDrex Max v1.1は275ミリ秒である。