
Base Labs、小規模QwenモデルにはRL前のSFTが有効だが大規模モデルには効果なしと判明
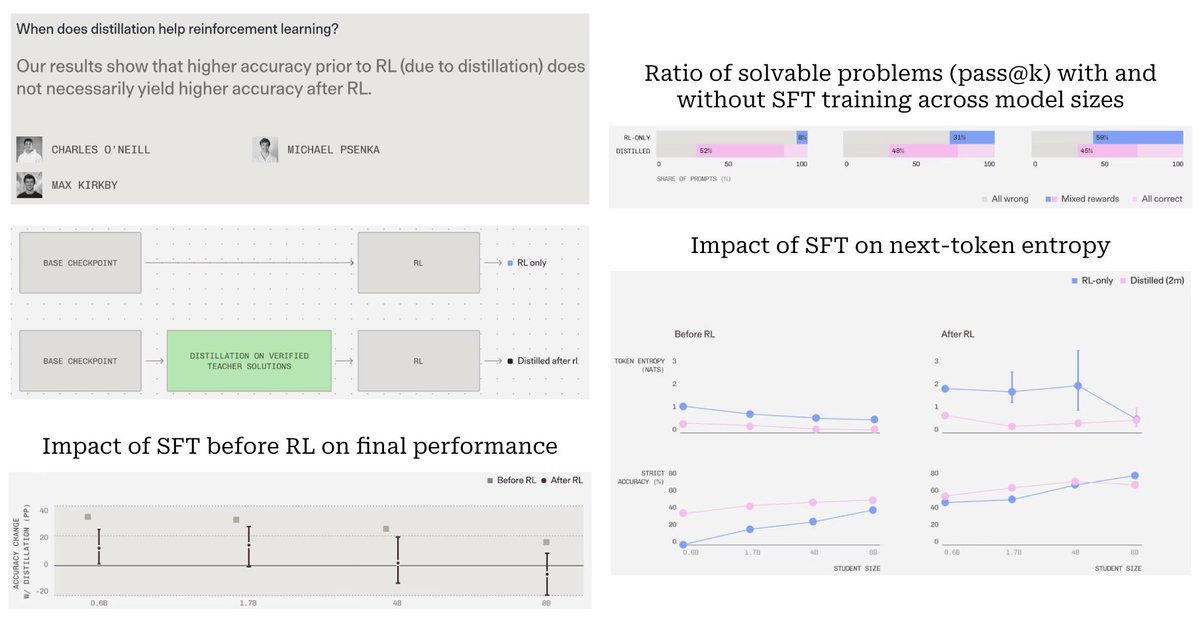
Base Labsは0.6B、1.7B、4B、8BのQwenモデルを、SFT+RLまたはRLのみで訓練した。GPT-5.6-Solが生成した推論トレースと16の合成Reasoning Gymタスクを使用。SFTは全モデルサイズでRL前の精度を向上させたが、RL後に恩恵を受けたのは0.6Bと1.7Bモデルのみで、4Bと8BモデルはSFTが次トークンエントロピーを低下させ探索を制限したため、ほとんどまたは全く向上しなかった。SFTデータを0.5Mから4Mトークンに拡大してもこれらの傾向は変わらなかった。
イベントのバージョン 1.
Key insights
SFTは全サイズでRL前精度を向上
SFTはテストした全モデルサイズでRL前のベースモデル精度を向上させた。しかし、RL前の精度向上がRL後の性能向上に常につながるわけではなかった。
小規模モデルはSFT+RLで恩恵
0.6Bと1.7BモデルはSFT+RLでより良い性能を示した。小規模モデルは多くの問題を解くのに苦労し、SFTがいくつかの正解を生成することを教えることでRLが進歩できる。
大規模モデルはSFTからほとんど恩恵なし
4Bと8BモデルはRL前のSFTからほとんどまたは全く恩恵を受けなかった。これらのモデルは複数の補完をサンプリングする際に正解を見つける能力が既に高いことが多く、SFTは次トークンエントロピーを測定可能な形で低下させ、探索を制限する。
SFTデータのスケーリングは一貫しない影響
SFTデータ量を0.5M、1M、2M、4Mトークンで変化させても観察された傾向は変わらなかった。SFTのスケーリングの影響はモデルサイズ間で一貫していない。
SFTは必要な場合のみ実行すべき
RLはGRPOが有用な学習信号を提供するために、モデルが各プロンプトに対して正解と不正解の応答を混合して生成する必要がある。SFTは次トークンエントロピーを低下させ探索を制限する可能性があるため、既に十分な問題を解ける大規模モデルはRLのみでより良い最終性能を達成できる場合がある。