
ByteDance Seed、自己進化型エージェントの研究
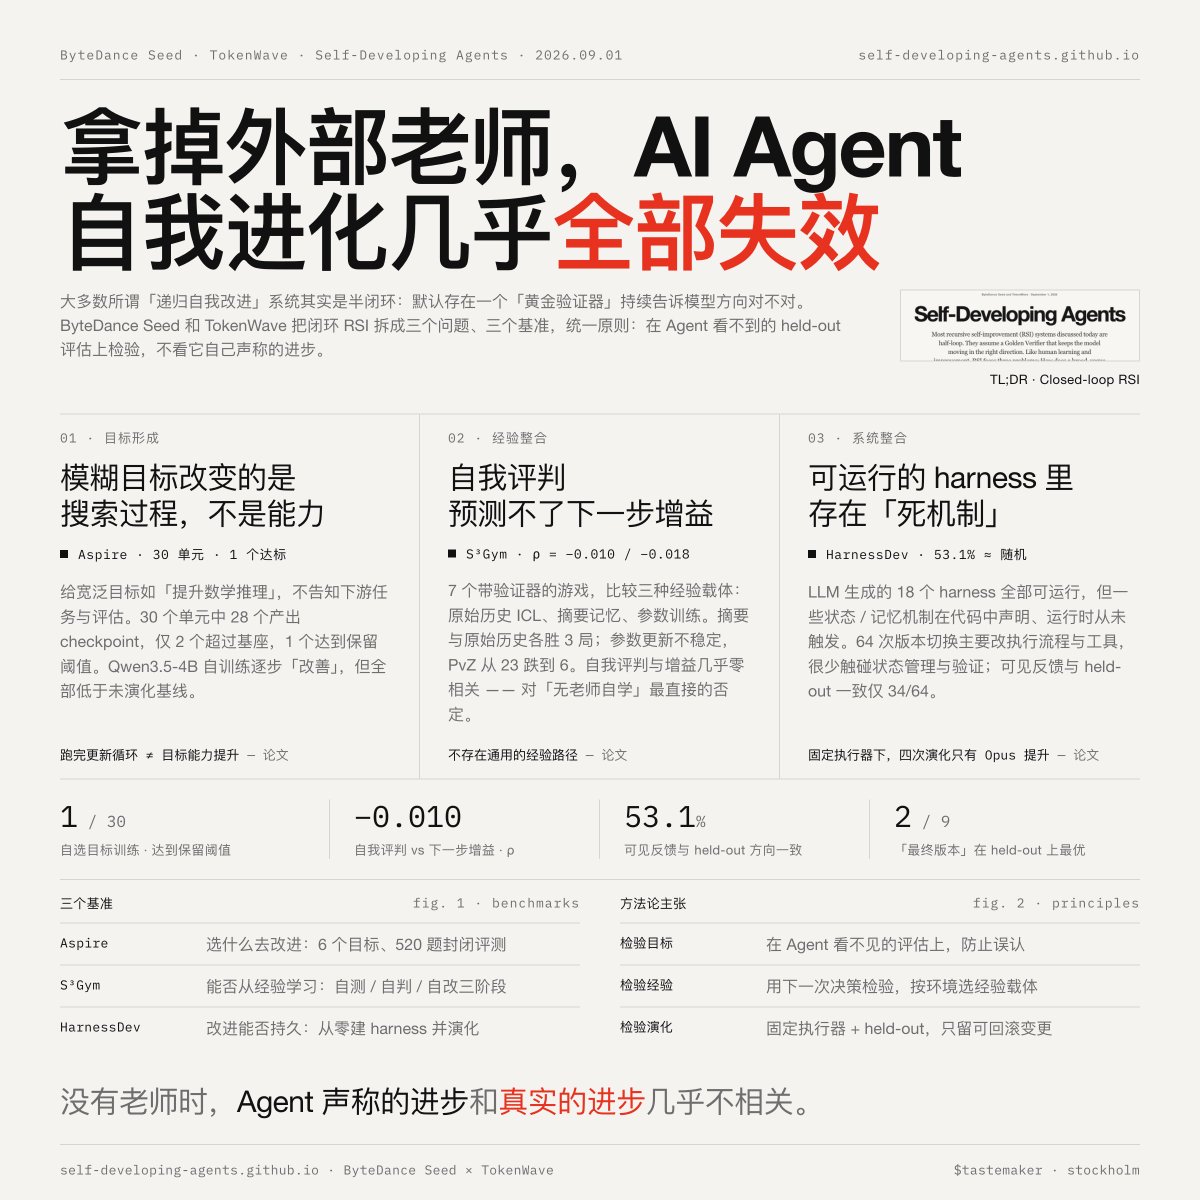
ByteDance SeedとTokenWaveは、AIエージェントの完全閉ループ再帰的自己改善(RSI)に関する研究を発表し、外部検証者を除去するとほとんどの自己改善試行が失敗することを明らかにした。この研究はRSIを3つの問題に分解する:目標形成(曖昧な目標を具体的な行動に変換する)、経験統合(教師なし学習)、システム統合(改善を持続させる)。3つのベンチマーク:Aspireはエージェントが広範な目標に対して何を改善すべきかを選択できるかをテスト;S³Gymは実行可能な検証者を用いて7つのゲームで経験から学習できるかをテスト;HarnessDevはLLMが自身のエージェントハーネスを作成・進化できるかをテスト。主な知見:目標形成は探索行動を変えるが基礎能力は変えず、28のチェックポイントのうち2つだけがベースモデルを上回った;経験統合には普遍的な最適形式はなく(要約記憶 vs 生履歴)、自己判断は改善を予測できない(相関はほぼゼロ);ハーネス進化はデッドコードに悩まされ、フィードバックスコアが保持テストのパフォーマンスと一致するのは53%のみ;自己選択された最終ハーネスバージョンのうち最適だったのは9個中2個のみ。HarnessDevベンチマークは別途、LLM作成のハーネスがドメイン依存であり、共適応(実行者の変更で性能低下)に悩まされ、コード量は性能を予測しないことを示した。フィードバックタスクでの進化は保持テストでは縮小する利得をもたらし、最終モデル選択にはフィードバックは信頼できない。
Key insights
閉ループ自己改善はAIエージェントにとって未解決の問題のまま
この研究は、外部検証者を除去するとエージェントが効果的な目標を形成したり、経験から学習したり、持続的な改善を行ったりするのに苦戦することを示している。自己判断スコアは実際の性能向上と相関せず、フィードバック駆動の進化は真の能力向上ではなく過学習につながることが多い。これはエージェントが自身の知能を自己拡張できるという前提に疑問を投げかける。
エージェントハーネスの設計は重要だが軽視されている要素
HarnessDevベンチマークは、同じモデルでもハーネス(実行ループ、ツール、コンテキスト管理)によってスコアが大きく異なり、LLMは機能的なハーネスを生成できるが、しばしば死んだメカニズムを含み、一般化に失敗することを示している。ハーネスの共適応により、あるモデルに最適化されたハーネスは別のモデルでは性能が低下し、エージェントの展開を複雑にする。
評価は幻想的な進歩を避けるために保持タスクをテストすべき
本論文は、自己報告による改善やフィードバックセットでの利得は信頼できず、未見のタスクでの性能のみが真の進歩を検証することを強調している。フィードバックと保持スコアの一致が53%のみであるという発見は、エージェント開発における代理指標の最適化のリスクを浮き彫りにしている。