
ChatGPTとClaudeにおけるメモリとコンテキスト戦略
メモリ戦略の比較:ChatGPT対Claude。
Key insights
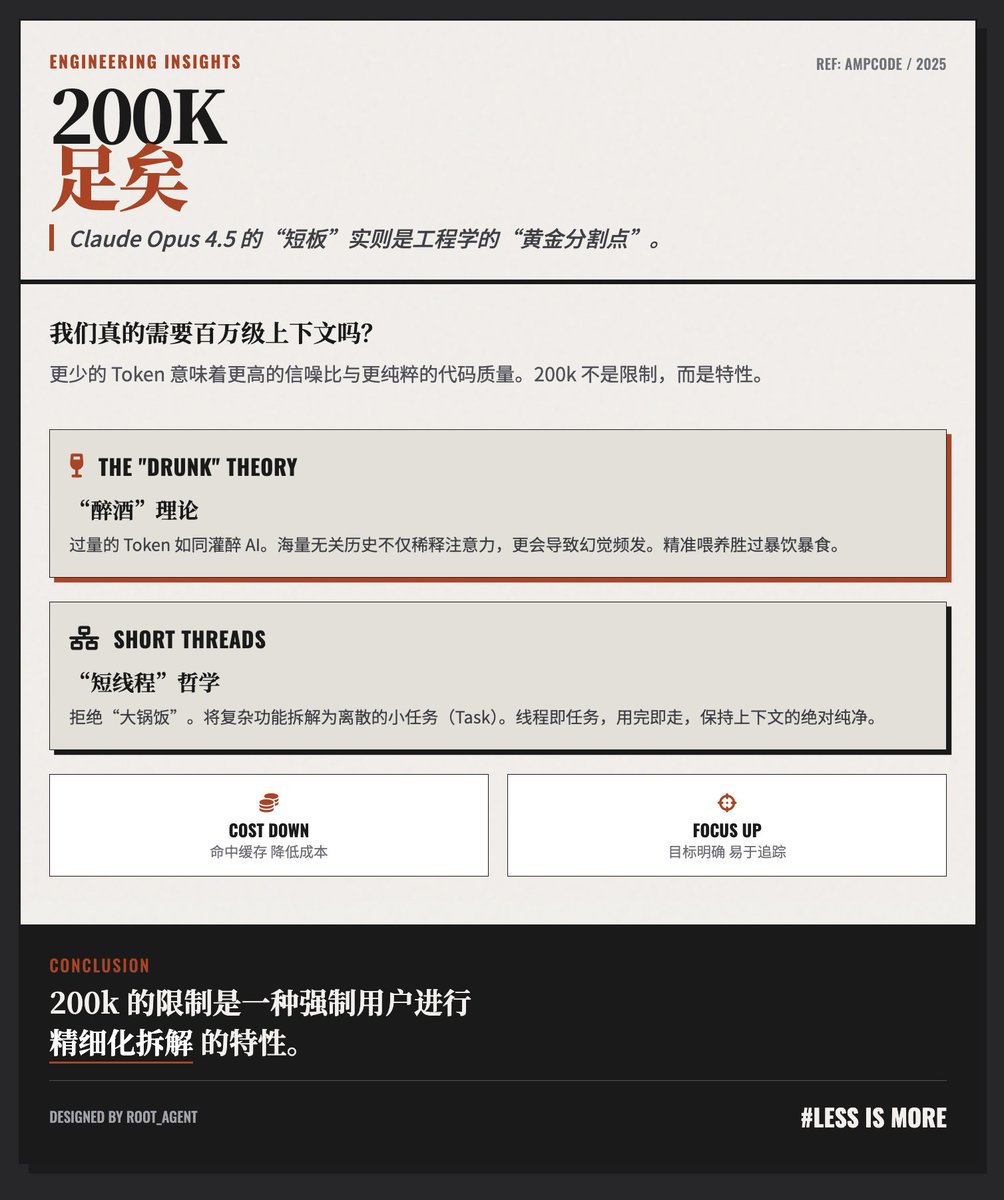
200Kトークンウィンドウは十分であり、時にはより良い
ある技術ブログは、200kトークンのコンテキストウィンドウ(Claude Opus 4.5)が高品質なコーディングとタスク実行に十分であり、過度に長いコンテキストは信号対雑音を低下させ、エージェントを「酔わせる」可能性があると主張しました。著者は、作業を複数の短いスレッドに分割し、それぞれが単一のサブタスクに集中し、スレッド間で必要なコンテキストのみを渡すことを推奨しています。この投稿は、200kの制限を欠陥ではなく、規律あるタスク分解を強制する機能として位置づけました。
ChatGPTは完全な注入と軽量要約を使用
ChatGPTのメモリシステムは、維持されたユーザーメモリと最近の10~15回の会話の軽量要約を各プロンプトに注入します。特定されたアーキテクチャ層には、一時的なセッションメタデータ、長期的なユーザーメモリ(編集可能)、最近の会話の要約(ユーザーのみのスニペット)、および現在のセッションウィンドウが含まれます。このシステムは、シームレスで迅速な応答と改善された会話の連続性のために、詳細解像度を少し犠牲にして、プロアクティブな取得よりも注入を好みます。
Claudeはオンデマンド取得とツールを使用して高忠実度のリコールを実現
Claudeのアプローチは、セッションコンテキストを最小限に保ち、過去の会話をオンデマンドで検索するために、conversation_searchとrecent_chatsという2つの取得ツールを使用します。長期的なメモリは、必要に応じてXMLのような形式で保存され、注入されます。これにより、過去のAI出力や特定のデータ構造の高忠実度の取得が実現されますが、追加のレイテンシーとツールを呼び出すモデルの決定に依存します。
トレードオフ:ChatGPTはシームレスなフローに優れ、Claudeは精度に優れる
強みの比較:ChatGPTは、各ターンで要約とメモリを注入するため、流動的な体験と迅速なコンテキスト切り替えを提供します。欠点には、潜在的な詳細の喪失や無関係な要約の干渉が含まれます。Claudeは無関係な履歴を避け、トークンを節約し、長期プロジェクトの精度を向上させますが、取得ツールを呼び出さない場合は遅くなるか「忘れた」ように見えることがあります。使用ケースは異なり、ChatGPTはコンパニオンのような対話や浅い連続性に適しており、Claudeは正確な過去のアーティファクトを必要とする長期プロジェクトに適しています。
ウェブ対応のLLM検索+調査パターンを使用して迅速な深い概要を得る
実用的なヒントとして、8語のLLMプロンプトパターンを推奨します:ネットワーク検索と要約の組み合わせ。このパターンは、モデルのウェブ取得と合成能力を利用して、数分で調査レベルの概要を生成します。これは、初期探索のために人間の単独研究よりも迅速で、しばしば高品質です。ワークフローの提案:LLM生成の概要を個人の知識システム(例:Logseq)にv1ノートとして保存し、段階的な知識の構築を行います。