
Claude Opus 5.5 のリリースと利用ガイダンス
AnthropicはClaude Opus 5.5をリリース。ほとんどの業務タスクでFable 5.1と同等の性能を、タスクあたり40%低いコストで実現。入力トークン100万あたり4ドル、出力トークン100万あたり20ドル、キャッシュ読み取りは60%低下して0.2ドル、出力速度は30%以上向上。Claudeアプリ、AWS、Google Cloud、Azureで利用可能。
Key insights
Terminal-Bench 4.0でGPT-6 Astraと同等、コストは約40%
Anthropicの独自比較では、Opus 5.5はマルチステップのコマンドラインベンチマークであるTerminal-Bench 4.0において、OpenAIのGPT-6 Astraと同等の性能を、約40%のコストで達成。同社は、この能力レベルではベンチマークスコアの差は実用上の違いを反映しなくなったと述べている。Web検索のみを使用して企業の四半期決算レポートを作成し、虚偽の数字や引用は失敗とみなす研究スタイルのテストでは、Opus 5.5は18件中16件のレポートに合格したのに対し、Fable 5.1とOpus 5は0件だった。
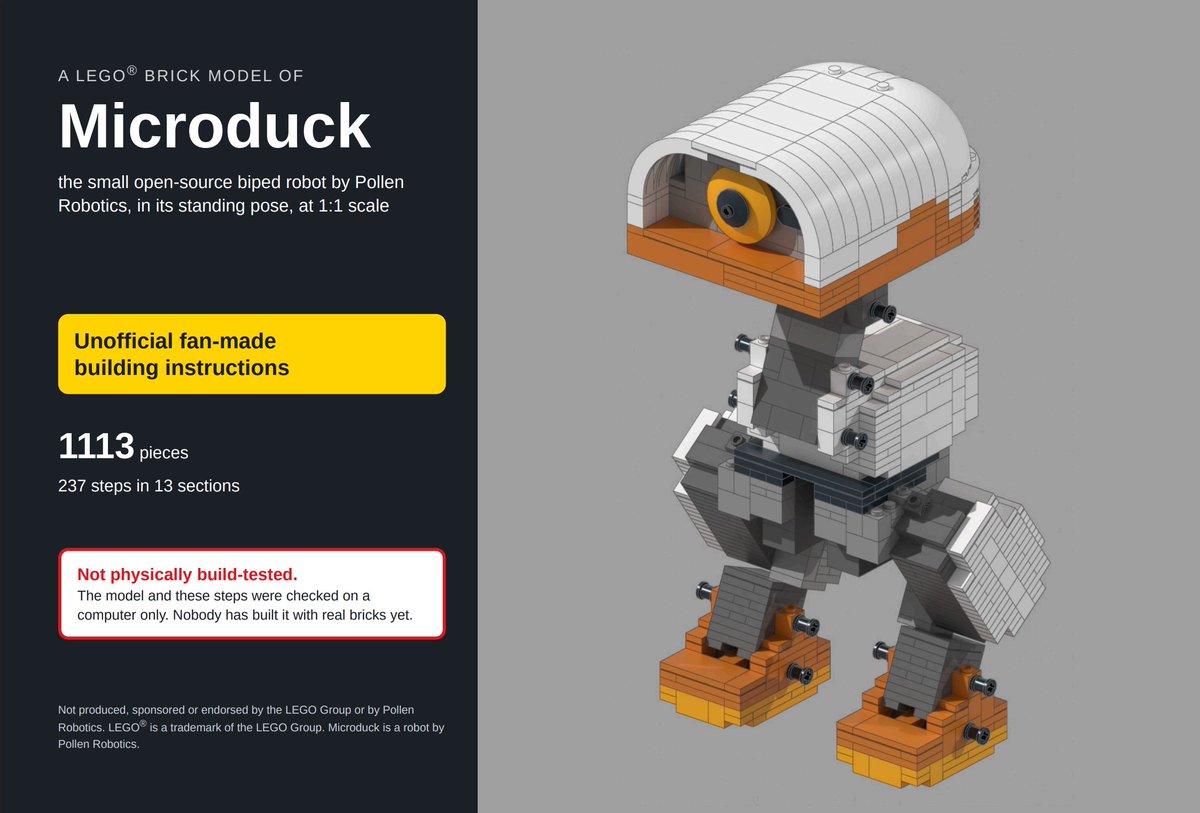
LEGO Microduckの組み立てが物理設計能力を示す
HuggingFaceのチームメンバーがClaude Opus 5.5に、同チームの完売したアヒルロボット「Microduck」を実際のLEGOブロックで組み立て可能な設計を依頼。モデルは、1,113個の実際のLEGOパーツを6色で1:1スケールで使用した設計を生成。3,204のパーツ接続すべてが3Dで一致し、衝突はゼロ。各ステップの新しいパーツは、既存のパーツを通過せずに組み立て方向に沿って挿入可能。推定重心は2フィートの支持範囲内。成果物には、141ページ、237ステップ、13章からなる公式スタイルの組み立てマニュアル、LDrawモデルファイル、CSVパーツリスト、BrickLinkのウィッシュリストXML、ブラウザでのパーツごとの価格チェックと準備済みの注文が含まれていた。
内部テストでOpus 5比の大幅な向上をコーディングとエージェントタスクで確認
初期テスターはOpus 5.5を使用して20万行のコードベースの監査と修正を3時間未満で完了。Opus 5では同じ作業に20時間以上かかり、2.5倍のトークンを消費した。Anthropic内部では、Opus 5.5とFable 5.1にロードバランシングソフトウェアHAProxyをCからRustに書き換えさせたところ、両方ともほぼすべての回帰テストに合格。Opus 5.5は9.5時間で完了(Fable 5.1は12時間)、コストは51%低かった。
新モデルにサイバーおよびバイオ関連の制限を同梱
Opus 5.5のサイバーセキュリティと生物学の能力はMythos 5.1のレベルに近づいているため、Fable 5.1の安全対策を継承している。自身のコードの脆弱性修正は許可されるが、ほとんどのサイバーセキュリティタスクは自動的に旧モデルのOpus 4.8にルーティングされ、生物学研究作業は制限される。大学や製薬会社はライフサイエンス検証プログラムに申請することで制限を解除できる。開発者向けの変更点が2つ:思考モードを無効にできなくなり、8月31日以降に登録されたAPIアカウントでは、履歴コンテキストを変更してモデルの推論を抽出することができなくなる(蒸留対策)。Anthropicは既存の統合環境で公式ドキュメントを確認するよう推奨している。
Anthropic、Opus 5.5向けに11のプロンプトとハーネス調整を発表
AnthropicはOpus 5.5に特化した11の調整方向を公開。主なポイント:努力度(effort)が主要な制御ノブであり、階層はモデル間で比較できない。5.5の中程度(medium)はOpus 5の高(high)と同等以上。max_tokensは余裕を持たせ、エージェント型コーディングでは128kを推奨。ハーネスはプレーンテキストのend_turn進捗レポートを単なるレポートとして扱い、チェックリストと再プロンプトで誤った完了を防止。進捗更新は思考ブロック内に存在するため、クライアントは更新を表示するか、メッセージングツールを追加する必要がある。メッセージごとに1行の経過時間シグナルを送ることで並列加速を促進。貼り付けたコンテンツはタグ付きブロックでラップし、インジェクションを防ぐ指示を追加。古いビジョンツールチェーンは再テストが必要。フロントエンドのプロンプトでは、AIらしさを避けるために特定のAIスタイル要素を禁止するよう具体的に指示し、一般的な要求は避ける。
能力プロファイル:コードレビュー、知識作業、ビジョンを強調
ガイダンスでは、プロンプトに関連する4つの強みを説明。エージェント型コーディングとコードレビューでは、中程度の努力でOpus 5の高階層に匹敵またはそれを上回り、より少ないステップとトークンで、数時間にわたる無人監査や移行をサポートし、見逃しや誤検出が減少。知識作業では、数値と引用のエラー率が大幅に低下し、財務モデリングや長文書内の隠れた矛盾(日付の不一致やデータと矛盾するグラフなど)の発見に強み。進捗報告は、何を行い、何を見つけ、何が必要かについてより直接的。視覚理解では、密度の高いチャートの最も低い努力での読み取りでも、Opus 5の最高努力よりも正確で、トークンはわずか。フローチャートの矢印やカレンダーのスクリーンショットなど、位置が意味を持つケースでより信頼性が高い。
キャッシュ経済がセッションあたり約31%の実質節約を実現
各ターンで以前のコンテキストを再送信するため、キャッシュ読み取りの価格設定が請求額の大部分を占める。Opus 5.5のキャッシュ読み取りが0.5ドルから0.2ドルに引き下げられたことで、平均的なセッションは約31%安くなる。44件のカスタマーサポートチケットのテストでは、Opus 4.8からの切り替えでコストが約18%削減され、プロンプトレビューを追加するとベースライン比で約25%の削減となった。Pro、Max、Teamサブスクライバーのクォータは約25%多くの使用量に換算される。実用的なヒントとして、無関係なタスクには/clear、キャッシュ期限切れ前には/compactを使用すること。APIキャッシュはサブスクライバーの1時間に対してわずか5分しか持続しないこと、モデル切り替え、MCPサーバーの切り替え、初回の高速モードではフルプライスのキャッシュ書き込みが発生することに注意。
推奨される努力度設定とマルチモデルによる役割分担
Opus 5.5のデフォルトは中程度の努力(medium)で、Opus 5のデフォルトの高(high)より一段階低いが、同じ階層でもより多くの思考を行うため、Opus 5用に調整された設定は引き継ぐべきではない。推奨パターンは、日常業務にはmedium、行き詰まった場合にはhigh、バッチリネームなどの機械的なタスクにはlow。モデルの役割分担については、ガイダンスでは日常業務はOpus 5.5で実行し、問題がxhigh努力でも2回行き詰まった場合にのみ、より高価なFable 5.1にエスカレーションしてから戻すこと。コード検索やログ読み取りのサブエージェントはSonnetやHaikuに任せ、コード作成はOpus 5.5に維持することを推奨。