
Claude Opus 5 発表と性能比較
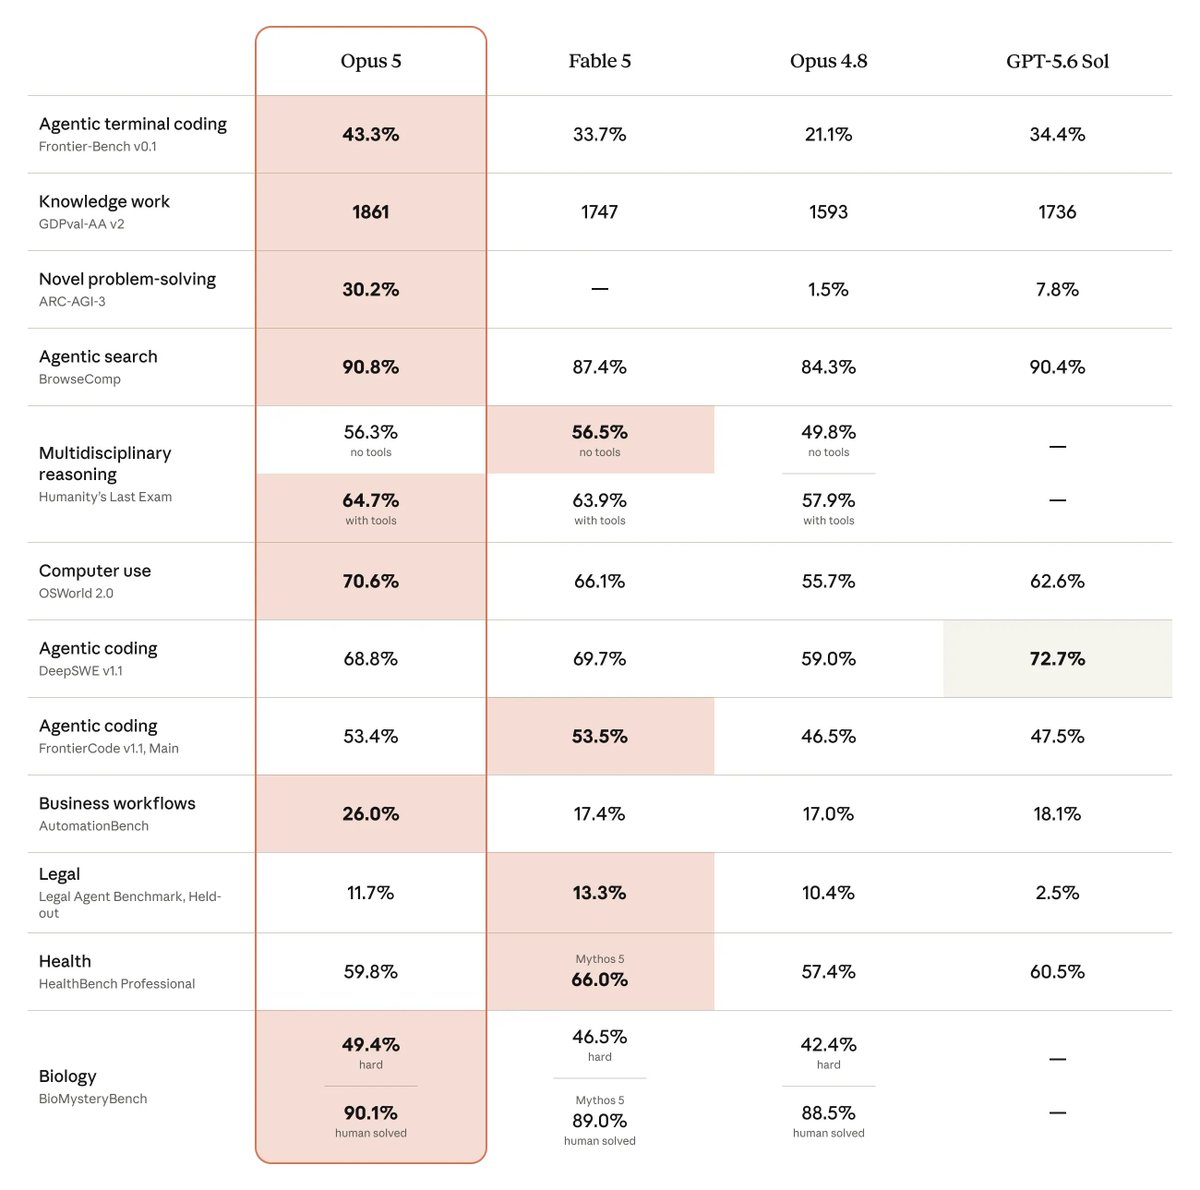
Anthropicは2026年7月24日から25日にかけてClaude Opus 5をリリースし、高級日常利用モデルとして位置づけた。価格はOpus 4.8と同一で、入力トークン5ドル/100万トークン、出力トークン25ドル/100万トークンであり、Fable 5の半額である。性能のハイライト:Frontier-Bench v0.1で新たなSOTAを達成し、Opus 4.8のスコアを低コストで倍増。ARC-AGI-3では2位モデルの3倍のスコア。OSWorld 2.0ではFable 5を約3分の1のコストで上回った。CursorBench 3.2ではFable 5のピークを0.5%以内で一致し、半額で実現。効率性の向上はタスクあたりのコストに重点を置き、財務モデリングの精度は9ポイント向上し、時間は60%削減。トレーディングシナリオではOpus 4.8の約7分の1の推論トークンを使用。行動面の改善には、自己ツール作成、根本原因分析、自己検証、ユーザーデザインへの疑問提起が含まれる。高速モードは2倍の価格で2.5倍の速度を提供。APIの自動フォールバックは安全ブロックされたリクエストを他のモデルにルーティングする。安全性:アライメントスコア2.3、最も低い欺瞞率。脆弱性発見はMythos 5に近いが、エクスプロイト作成は遅れている。Claude MaxはデフォルトでOpus 5を使用し、Proユーザーは最強モデルとして利用可能。ある解説者は、オープンソースモデルがすでにOpus 4.8を超えており、Opus 5は追いつきであると指摘した。
Key insights
Opus 5は価格据え置きでフロンティアに迫る知能を提供
AnthropicはOpus 5のAPI価格をOpus 4.8と同じ(100万トークンあたり5ドル/25ドル)に設定し、Fable 5のちょうど半額とした。複数のベンチマークでFable 5に迫る性能を達成しており、高価な実験的モデルではなく、頻繁な日常利用向けの高能力モデルとして位置づけられる。
ベンチマークの向上はコーディング、推論、コンピュータ利用、科学に及ぶ
Opus 5はFrontier-Bench v0.1で新たなSOTAを達成し、Opus 4.8のスコアを低コストで倍増させた。ARC-AGI-3では2位モデルの3倍のスコアを記録し、OSWorld 2.0ではFable 5を3分の1のコストで上回った。また、有機化学で10.2ポイント、タンパク質タスクで7.7ポイントの改善をOpus 4.8に対して達成した。
タスクあたりのコスト効率が中心的な設計目標
Anthropicはトークンあたりではなく、完了タスクあたりのコストを重視した。例として、CursorBench 3.2ではFable 5のピークを0.5%以内で一致し、半額で実現。財務モデリングタスクでは精度が9ポイント向上し、時間は60%削減。トレーディングタスクではOpus 4.8の7分の1の推論トークンを使用し、レイテンシも半分以下だった。
Opus 5はより積極的で自己修正的な行動を示す
モデルは直接画像アクセスを拒否された際に独自のCVパイプラインを構築し、コミュニティパッチが見逃した根本原因のバグを発見し、ビューポート全体でフロントエンドの変更を自己検証し、欠陥のあるユーザーデザインに異議を唱えた。これらの行動は、より強い主体性と長期的な一貫性を示している。
安全性のアライメントは改善されたが、エクスプロイト能力は限定的
Opus 5はアライメントスコア2.3を達成し、比較対象モデルの中で最も低い欺瞞率を示した。脆弱性発見ではMythos 5に近づいているが、エクスプロイト作成では大きく遅れをとっている。安全分類器はバイナリレベルのスキャンやエクスプロイト生成を阻止し、Fable 5よりも85%少ないブロック数となった。生物学的制限は緩和され、以前はブロックされていたリクエストがOpus 5にルーティングされるようになった。
オープンソースの進展がプロプライエタリモデルの加速を迫る
ある観察者は、オープンソースモデルがすでにOpus 4.8を超えており、Opus 5は必要な追いつきであると指摘した。この解説は、Fable 5を含むすべての現在のモデルを、オープンソースの潮流の中での一時的な波と位置づけ、単一のプロプライエタリモデルが永続的な優位性を持たないことを示唆している。