
Cohere、vLLMを凌駕するメガカーネル推論システムをオープンソース化
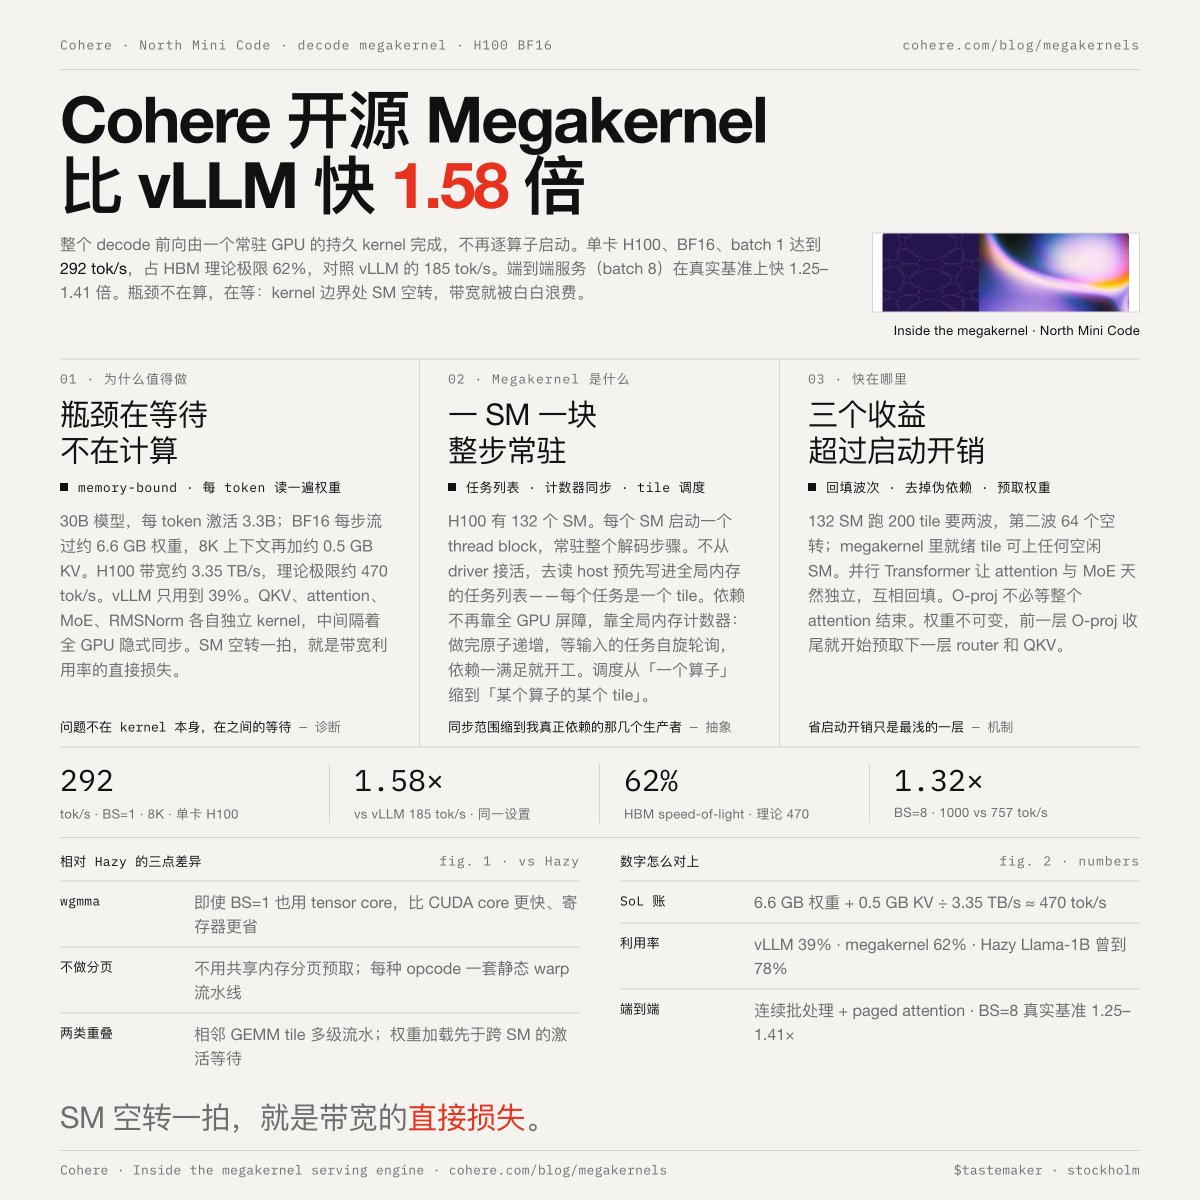
Cohereは、LLM推論向けのデコードメガカーネルサービスシステムをオープンソース化した。BF16精度の単一H100上で、バッチサイズ1において292トークン/秒(H100帯域幅制限の62%)を達成し、vLLMの185トークン/秒(1.58倍高速)を上回る。バッチサイズ8でのエンドツーエンドサービスは、実際のベンチマークで1.25~1.41倍高速。本システムは、グローバルメモリキューからタスクを読み取る永続カーネルを各SMに保持することで、カーネル起動オーバーヘッドと粗い同期を排除する。主な改善点:ウェーブ量子化ギャップの解消、細粒度カウンターによる誤った依存関係の除去、および積極的な重みプリフェッチ。Cohereは自社の30Bパラメータモデル「North Mini Code」向けに構築した。
Key insights
メガカーネル設計によりデコードスループットが大幅に向上
Cohereのオープンソースメガカーネルシステムは、デコードステップ全体にわたりSMごとに永続的なスレッドブロックを維持する。タスクはホストが書き込むグローバルメモリキューからフェッチされる。同期にはGPU全体のバリアではなくアトミックカウンターを使用する。これにより、カーネル起動オーバーヘッドの排除、ウェーブ量子化による利用率低下の抑制、誤った依存関係の除去が実現される。H100上でのバッチ1デコードは292トークン/秒に達し、vLLMの185トークン/秒の1.58倍高速である。
パフォーマンス向上はカーネル起動の節約にとどまらない
より深いメカニズムとして3つ挙げられる:(1)カーネルタイル数がSM数で均等に割り切れない場合の未使用SMサイクルの活用、(2)1つの出力がカーネル全体の終了を待つ誤った依存関係の排除、(3)アクティベーションが準備できる前に不変重みをプリフェッチ。Cohereのシステムはバッチ1でもテンソルコア(wgmma)を使用し、共有メモリのページングバグを回避し、マルチレベルパイプラインオーバーラップを実装している。
Cohereの30Bモデル「North Mini Code」向けに構築
本システムはCohereのNorth Mini Code(30Bパラメータモデル)向けに設計されている。各トークンは3.3Bパラメータを活性化し、BF16で約6.6GBの重み、8Kコンテキストで約0.5GBのKVキャッシュを必要とする。H100のHBM帯域幅は約3.35TB/sで、理論限界は約470トークン/秒である。vLLMはその39%(185トークン/秒)しか達成できなかったが、Cohereのメガカーネルは62%(292トークン/秒)に達する。