
EXPO-FT:ロボティクス向けの汎用ポストトレーニング手法
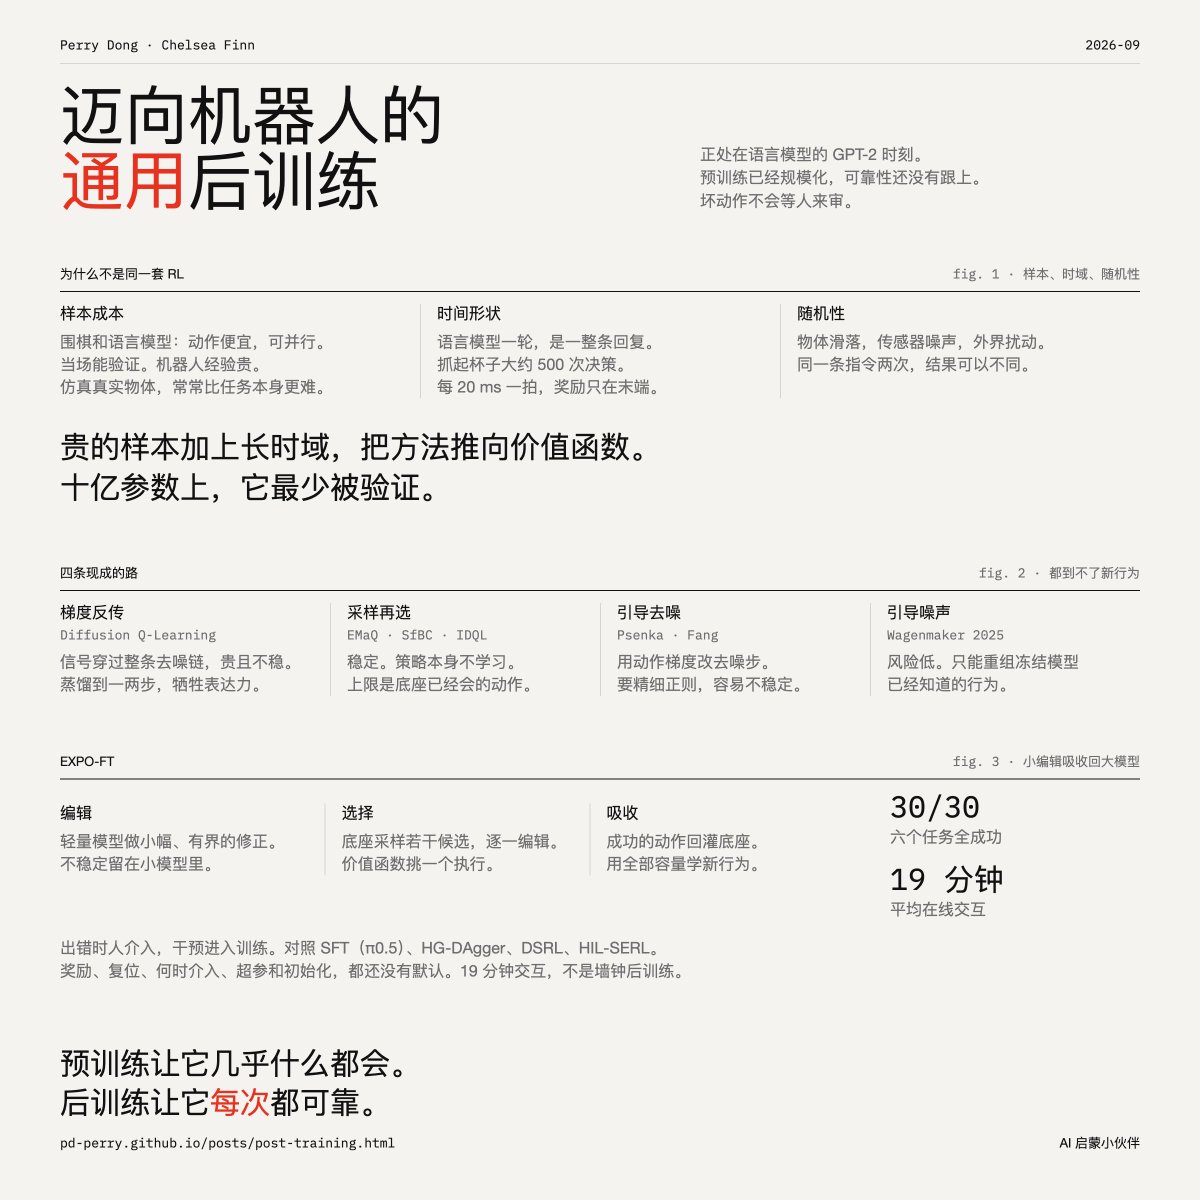
ある論文が、RLHFとRLVRが言語モデルにもたらしたのと同等の変革をロボティクスにもたらすポストトレーニング手法EXPO-FTを提案した。この手法は、幅広い能力を備えつつも不安定な事前学習済みVLAロボットを信頼性の高いものへと転換する。6つのマニピュレーションタスクにおいて、約19分のオンライン相互作用で30回中30回の成功を達成し、pi0.5へのSFTやHIL-SERLなどのベースラインを上回った。
Key insights
ロボティクスはいまGPT-2の段階にあり、ポストトレーニング手法を欠いている
著者らは、ロボティクスがRLHF以前の言語モデルと似た状況にあると論じる。VLAおよびワールド・アクションモデルの事前学習はスケールし、幅広いものの不安定な能力をもたらした一方で、この分野には「できる」を「毎回確実に実行できる」へと転換する、標準化された再利用可能なポストトレーニング手法が存在しない。言語モデルは、教師あり指示チューニング、RLHF、そして検証可能な報酬を用いた強化学習という共通のパイプラインに収束しており、報酬ハッキングの監視を備えたリファレンスモデルがこれを支えている。ロボットの誤った動作は人間による確認を待たずに即座に発生するため、ロボティクスにはより厳格な信頼性要件を満たす同等の枠組みが必要とされる。この手法には、極めて少ない実経験から学習する10億パラメータ規模のモデル上で安定して動作するアルゴリズムと、成功の定義、シーンのリセット、人間のフィードバックを規定するプロトコルが求められるが、これらはロボティクスにおいて依然として手作業にとどまっている。
ロボットの強化学習はLLMの強化学習と3つの構造的側面で異なる
サンプルコストの制約により、履歴データのオフポリシー再利用が不可避となる。ロボットの経験は高コストであり、実物体のシミュレーションはタスク自体よりも困難な場合がある。これは、囲碁やLLMにおける安価で並列的かつ検証可能なアクションとは対照的である。時間構造もクレジット割り当てを困難にする。ロボットは20ミリ秒の制御ステップや、カップを掴むまでに約500回の意思決定といった、数百から数千に及ぶ連鎖的な低レベル意思決定を行い、報酬はその連鎖の最後にのみ現れる。さらに、物体の落下、センサーノイズ、外部擾乱に起因する確率的変動がクレジット割り当てを一層混乱させる。これらの要因が相まって、ロボティクスは価値ベース強化学習へと向かうが、これはまさに10億パラメータ規模において最も検証が進んでいない手法群である。
除外マップが示す既存手法の限界
拡散ノイズ除去を介した勾配逆伝播、すなわちDiffusion Q-Learning系の手法は高コストで不安定であり、1〜2ステップへの蒸留は表現力を犠牲にする。EMaQ、SfBC、IDQLといったサンプル後に選択する(sample-then-select)手法は安定しているものの、ポリシー自体が学習せず、性能はベースモデルの提案能力が上限となる。アクション勾配によってノイズ除去ステップを誘導するには繊細な正則化が必要であり、入力ノイズ空間での誘導は凍結されたモデルの挙動を再結合するのみで、スキルの上限は事前学習によって画定される。より深い問題として、古典的な価値ベース強化学習はガウス単峰型ポリシーを仮定するのに対し、最先端モデルは拡散やフローを通じてマルチモーダルな挙動を表現する。さらに、ブートストラッピング(自身の未来予測を正解として扱い学習する手法)は、10億パラメータ規模では不安定性へと増幅される。
EXPO-FTは小型エディタとベースモデル間で役割を分担
この手法は3段階で構成される。軽量な編集ポリシー(edit policy)は、ベースモデルの候補アクションに対して境界付きの小さな修正を加え、モード内の価値のピークへと押し進める。これにより強化学習の不安定性を小型モデル内に封じ込め、大型モデルが危険なアクションを生成することを防ぐ。実行時には、ロボットがベースモデルから複数の候補をサンプリングし、それぞれを編集した上で、価値関数が最良のものを選択する。続く吸収(Absorption)段階では、選択された成功アクションをベースモデルの学習に書き戻す。これにより、小型エディタが発見した改善点は、ノイズ空間の再結合ではなく、真に学習された挙動としてベースモデルの全容量に吸収される。人間は監督者として機能し、エラー発生時に介入し、その介入データは学習に取り込まれる。これはWaymoのリモートセーフティオペレーターに類似する仕組みである。
6つのマニピュレーションタスクで30回中30回の成功
フックの周囲でのイルミネーションライトの配線と接続、ビリヤードのポケット入れ、花瓶への花の活け込み、卵をひっくり返す動作、ボールのバランス保持といった6つの複雑なマニピュレーションタスクにおいて、EXPO-FTは平均わずか19分のオンライン相互作用で30回中30回の成功を達成した。これは、pi0.5へのSFT、HG-DAgger、DSRL、HIL-SERLを含むベースラインの平均成功回数(おおむね5.5〜20.5回の範囲)を大幅に上回る結果である。
プロトコルが収束するまで汎用性は未解決のまま
著者らは、この手法がプラグアンドプレイとなる前にコミュニティが解決すべき課題を列挙している。第一に、ロボティクスにはRLVRに相当するものが存在しないため、報酬をどのように指定するかという問題(学習型の成功分類器や報酬モデルが有望な方向とされる)。第二に、リセットを誰が実行するかという問題(学習されたリセットポリシーや可逆的なタスク設計が選択肢として挙げられる)。第三に、人間がいつ、どの程度介入し、その入力をどのように活用するかという問題。第四に、学習率、UTD比、停止基準、ホライズン、制御頻度といったデフォルトのハイパーパラメータ。第五に、初期化データの重み付け方法である。彼らはこの収束に向けた第一歩として、EXPO-FTのチューニングリファレンスを公開している。