Google Android Bench 2.0、実際のAndroidタスクでAIエージェントを評価
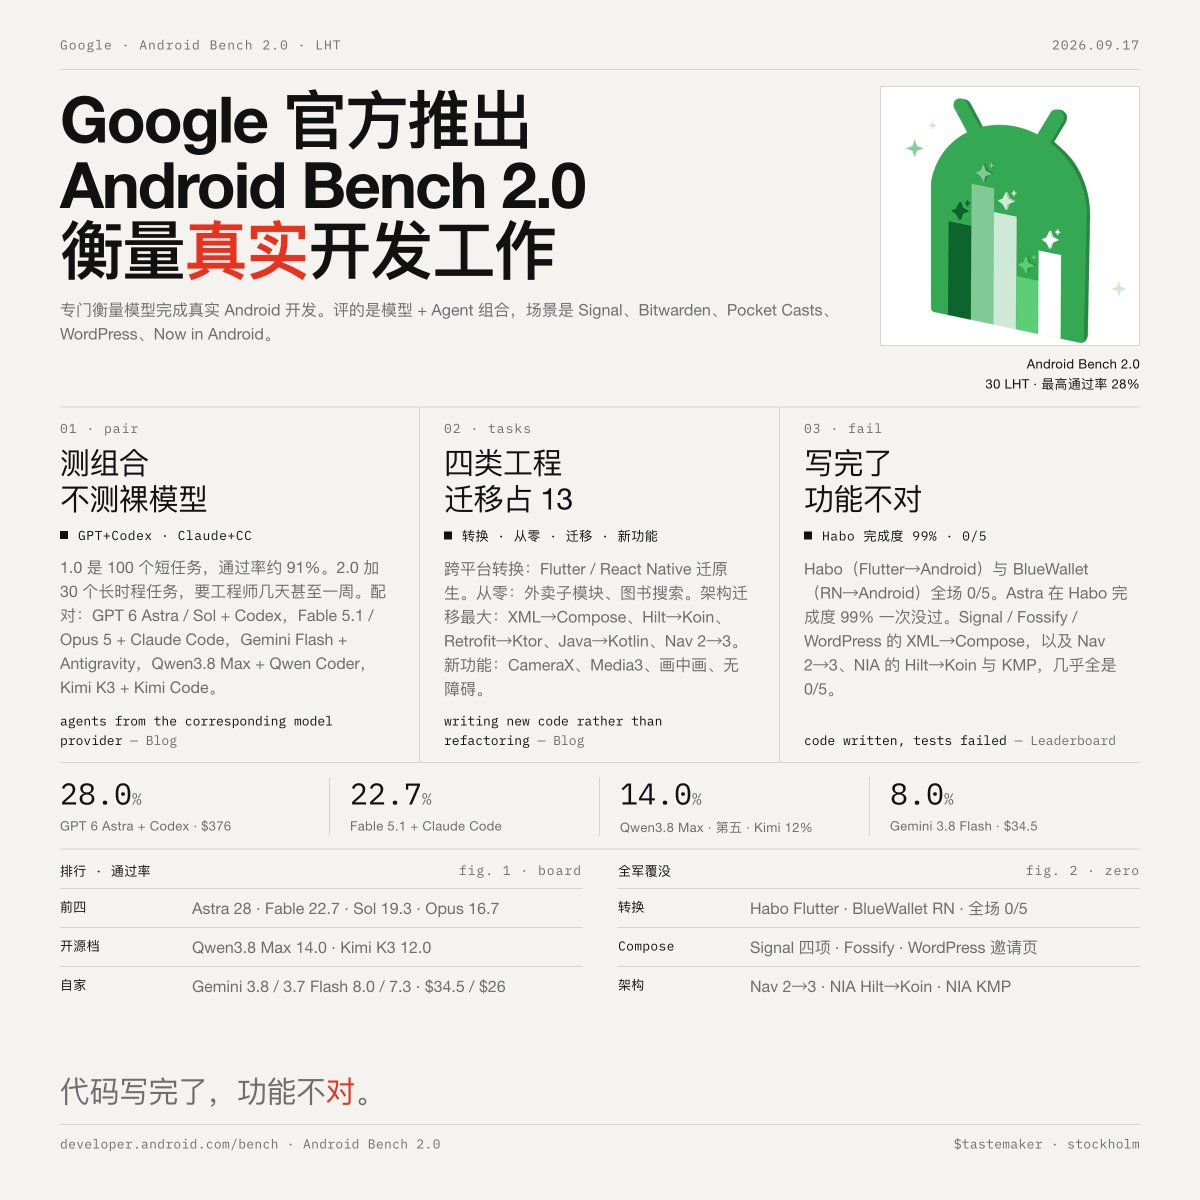
Googleは、実際のAndroid開発タスクにおけるモデルとエージェントの組み合わせを評価するベンチマーク「Android Bench 2.0」を公開した。GPT-6 Astra + CodexとClaude Fable 5.1 + Claude Codeがリードしたが、多くのタスクで合格率がゼロとなり、特にXMLからComposeへの移行やクロスプラットフォーム変換が困難であった。

Googleは、実際のAndroid開発タスクにおけるモデルとエージェントの組み合わせを評価するベンチマーク「Android Bench 2.0」を公開した。GPT-6 Astra + CodexとClaude Fable 5.1 + Claude Codeがリードしたが、多くのタスクで合格率がゼロとなり、特にXMLからComposeへの移行やクロスプラットフォーム変換が困難であった。