
Google DeepMind、Gemini 3.8 Live音声モデルを発表
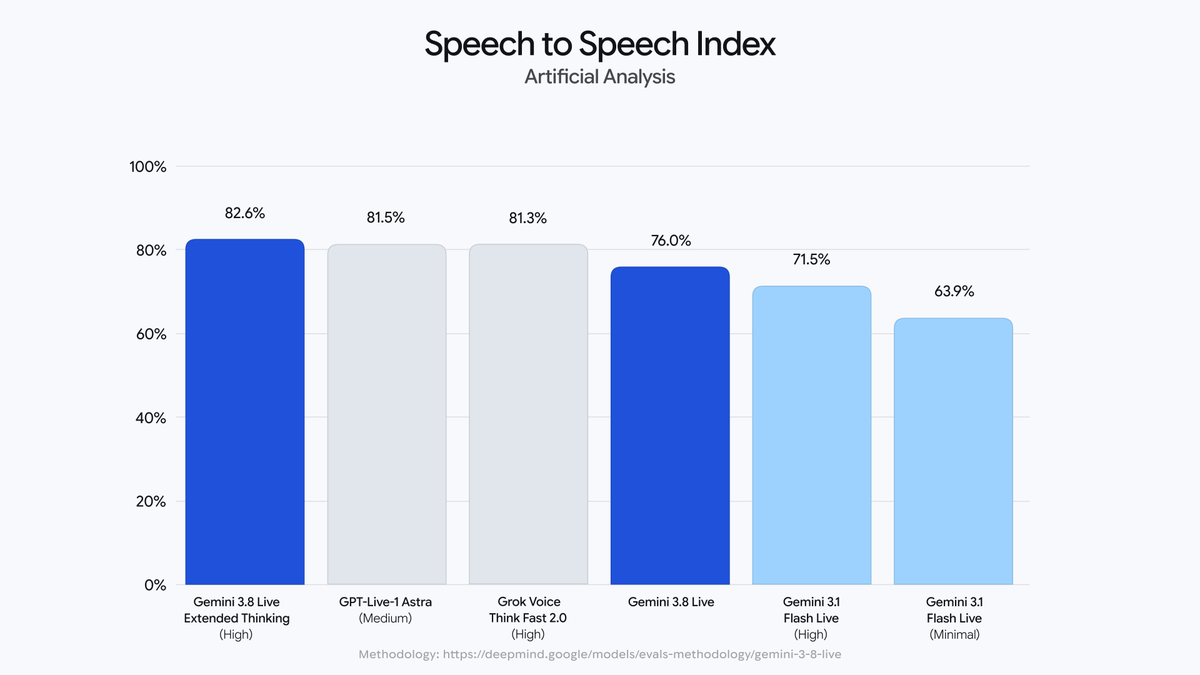
Google DeepMindは、最先端の対話型AIモデルであるGemini 3.8 Liveおよび3.8 Live Extended Thinkingを発表した。これらのモデルは97言語に対応し、ほぼリアルタイムの視覚理解、バックグラウンドでのツール呼び出しをサポートし、GeminiアプリおよびGemini APIを通じて利用可能である。
Key insights
新しいSOTAライブ音声モデルが登場
Google DeepMindは、これまでで最良の対話型AIとされるGemini 3.8 Liveおよび3.8 Live Extended Thinkingを発表した。3.8 Liveモデルは97言語に対応し、シームレスな言語切り替え、非同期ツール呼び出し、フロンティア級の性能を備える。Extended Thinking版は、困難なタスクに向けて性能と精度をさらに高め、処理の進行状況を説明しながら会話を継続する。
モデルは高度な推論とマルチモーダル機能を搭載
これらのモデルは、強化された推論、ほぼリアルタイムの視覚理解、97言語の自動言語検出を特徴とする。重要な機能の1つがバックグラウンドでのツール呼び出しであり、プログラミング学習用チューターのユースケースで示されたように、ユーザーの会話の流れを妨げずにAIがタスクを実行できる。
利用可能性と開発者向けアクセス
これらのモデルは、Geminiアプリ内のGemini Liveでテストでき、開発者はGoogle AI Studioを通じてGemini APIで利用できる。翌週にはサンフランシスコで対面式のGemini Audio体験イベントが予定されており、新モデルが紹介される。