
Google DeepMind、再帰的自己改善「Dream-RSI」を実証
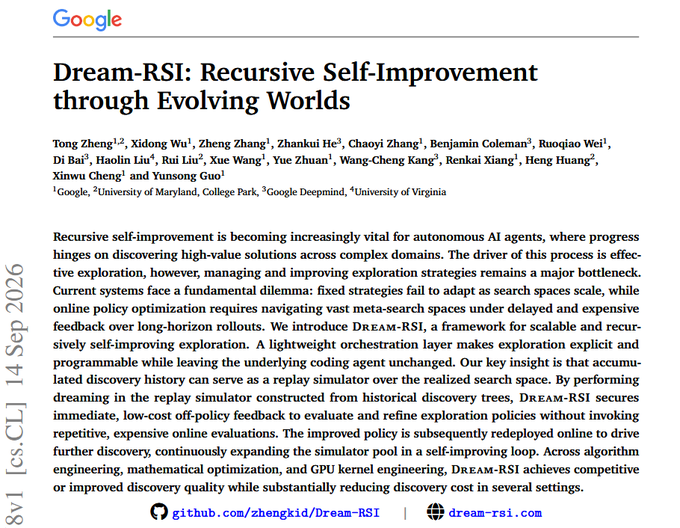
Google DeepMindは、過去の発見を再生し、低コストで数千の探索戦略をテストできる再帰的自己改善ループ「Dream-RSI」を発表した。アルゴリズム設計、数学的最適化、GPUカーネルエンジニアリングにおいて、結果の品質を維持または向上させながら、エージェント呼び出し効率を最大162倍改善した。
Key insights
Dream-RSIは過去の発見を再生し、低コストで新たな戦略をテスト
Dream-RSIは過去の発見プロセスを再生し、システムが低コストで数千の探索戦略をテストできるようにする。最良の戦略は次の実際の発見ラウンドで使用される。これにより、システムが自身の探索手法を改善する閉ループが形成される。
品質を維持しながらエージェント呼び出しを最大162倍削減
アルゴリズム設計、数学的最適化、GPUカーネルエンジニアリングのタスクにおいて、Dream-RSIは結果の品質を維持または向上させながら、エージェント呼び出しを最大162倍削減した。これは自己改善ループにおける顕著な効率向上を示している。