
Google Geminiエコシステム:ライブAPI、エージェントおよびマルチモーダル機能
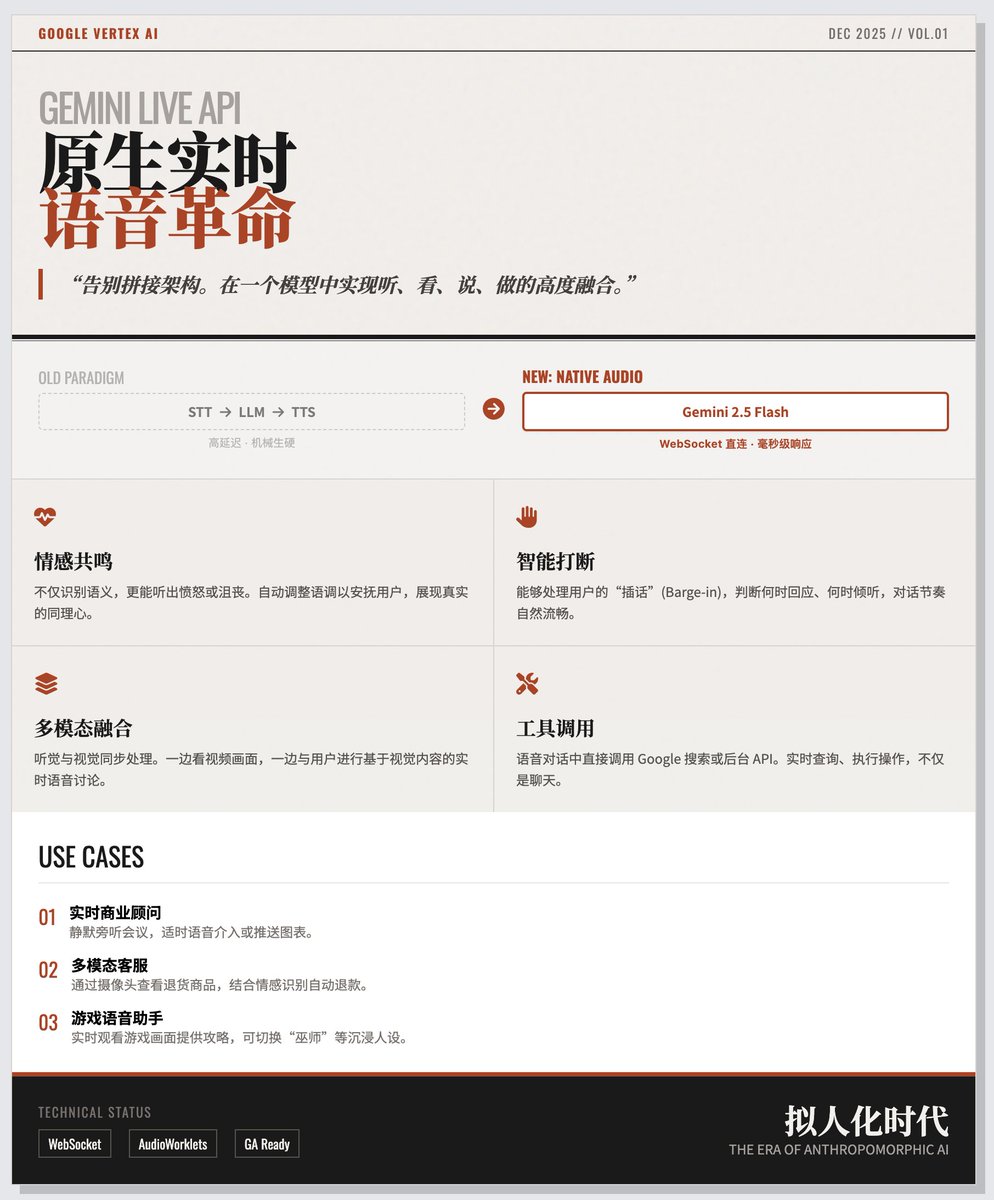
GoogleはGemini Live APIとInteractions API、そして新しいマルチモーダルエージェントを発表しました。 - Gemini Live APIはGemini 2.5 Flash Native Audioモデルを使用しています。 - ネイティブオーディオ処理により、STT/TTSの連鎖が排除され、レイテンシが低下します。 - Live APIはオーディオ、ビデオ、テキストを1つのWebSocketストリームで処理します。 - 機能:感情検出、中断可能な応答、ツール呼び出し、持続的なメモリ。 - クイックスタートテンプレート:バニラJSおよびReact。 - デモアプリ:リアルタイムビジネスアドバイザー、マルチモーダルカスタマーサービス、ゲーム音声アシスタント。 - Gemini TTSはプロンプト制御の音声属性(性別、トーン、年齢、発音)を許可します。 - Gemini Deep Research AgentはGemini 3 Proに基づいて構築され、自律的な計画と検証可能な引用を提供します。 - Deep ResearchはDeepSearchQA、Humanity's Last Exam、BrowseCompでSOTAを達成しました。
Key insights
Gemini Live APIはネイティブオーディオのマルチモーダル低レイテンシパイプラインを提供
GoogleはGemini 2.5 Flash Native Audioに基づくGemini Live APIを発表し、生のオーディオを「聞き」、直接オーディオ応答を生成する単一モデルストリームを可能にしました。これにより、STTおよびTTSの別々のステップが不要になります。このAPIはWebSocket接続を使用し、ミリ秒単位のレイテンシをサポートし、感情認識や中断可能な対話が可能で、ライブ会話中に外部ツールを呼び出したり検索したりできます。Googleは開発者の採用を加速するために、テンプレート(バニラJS、React)やデモシナリオを提供しました。
Gemini TTSと音声制御がマルチモーダル表現力を拡大
Googleの新しいGemini TTSモデルは、性別、トーン、年齢、特定の単語の発音などの音声属性に対するプロンプトレベルの制御を受け入れ、音声モデルを切り替える必要を排除します。開発者は、インタラクティブメディアのために異なるキャラクターの声を生成するためにTTSを使用し、Geminiの画像モデルをシーンビジュアルとTTS音声制御と組み合わせて報告しています。
Gemini Deep Research Agentは引用を伴う自律的な厳密な研究を目指す
DeepMindはGemini 3 Proに基づいて構築されたGemini Deep Research Agentを紹介しました。このエージェントは、自律的に研究を計画し、ターゲット検索を実行し、結果を読み取り、ギャップを特定し、再照会することを目的としています。プライベートドキュメントと公共の情報源を統合し、明示的な引用を伴う検証可能な出力を目指しています。このエージェントは、内部で公開されたDeepSearchQA(66.1%)、Humanity's Last Exam(46.4%)、BrowseComp(59.2%)でSOTAを達成し、Interactions APIを介して利用可能です。
Geminiプラットフォームはツール選択とUI動作を開発者に公開
開発者は、「画像を作成」オプションの選択がツールの呼び出しにどのように影響するかを説明しました:チェックされていない場合、文脈が示すとLLMは画像ツールを呼び出す可能性があります;チェックされている場合、システムプロンプトは画像生成を強制します。Geminiアプリやその他のチャットアプリは、生のLLM APIをツール定義、検索コネクタ、および外部ツールが呼び出されるタイミングや種類を決定するUI動作でラップしています。