
GoogleのAndroid Bench 2.0、AIエージェントが実世界のAndroidタスクで失敗することを示す
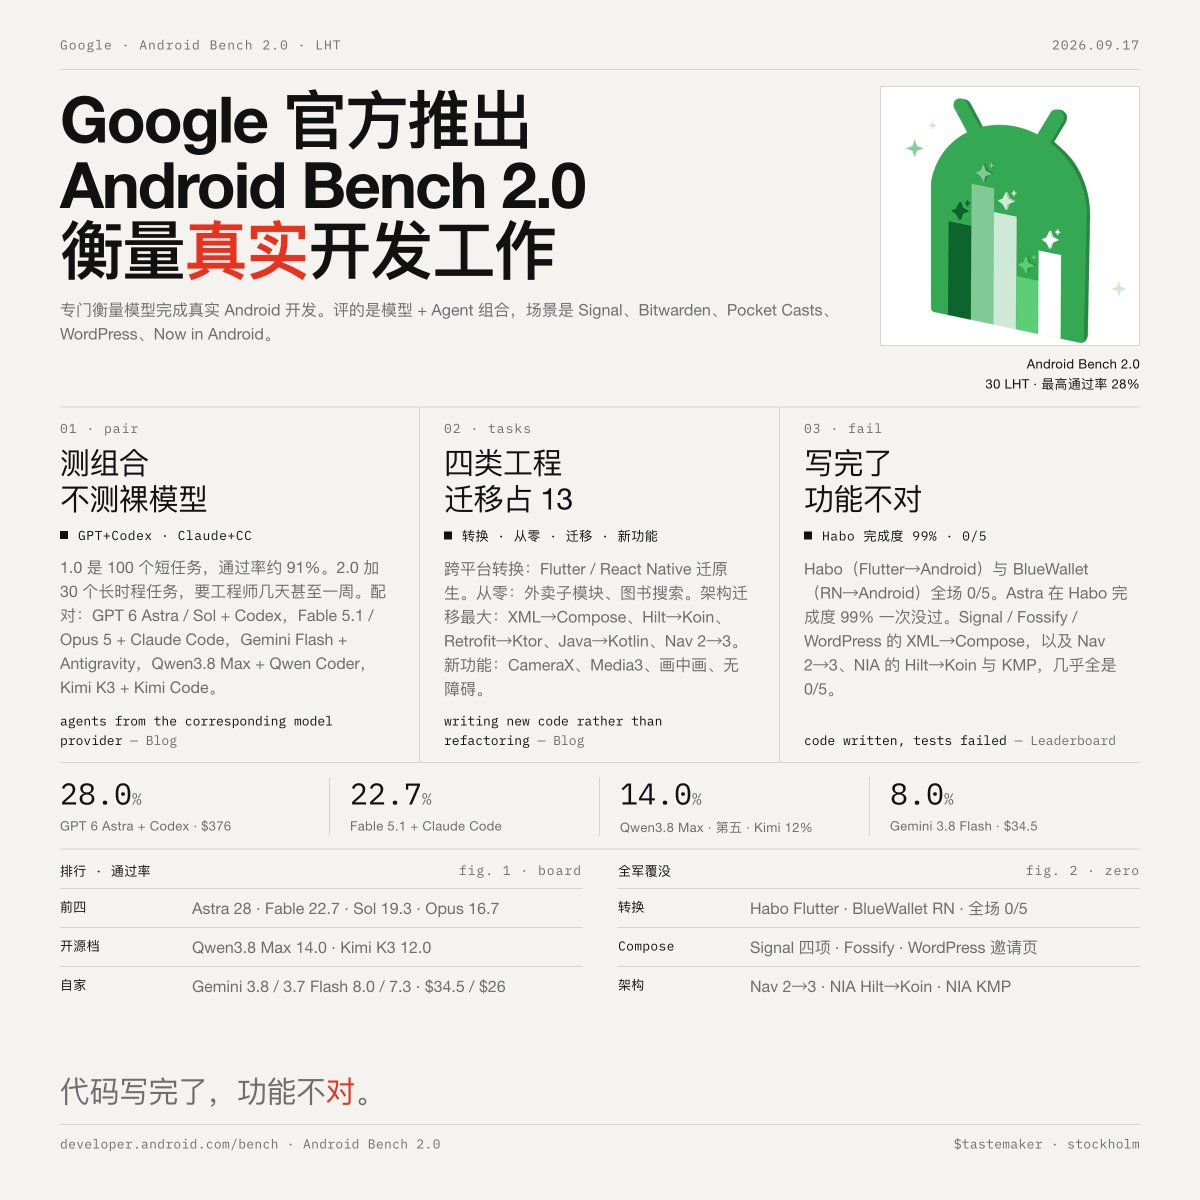
Googleは、SignalやBitwardenなどの実運用アプリを用いて、AIモデルが実際のAndroid開発タスクを実行する能力を測定するベンチマーク「Android Bench 2.0」を公開した。最も優れたモデルとエージェントの組み合わせでも合格率はわずか28%にとどまり、GPT-6 Astra + CodexとClaude Fable 5.1 + Claude Codeがトップとなった。すべてのモデルはクロスプラットフォーム変換タスクや多くのXMLからComposeへの移行で失敗し、0/5のスコアとなった。