
GPT-6 Astra の性能と導入状況
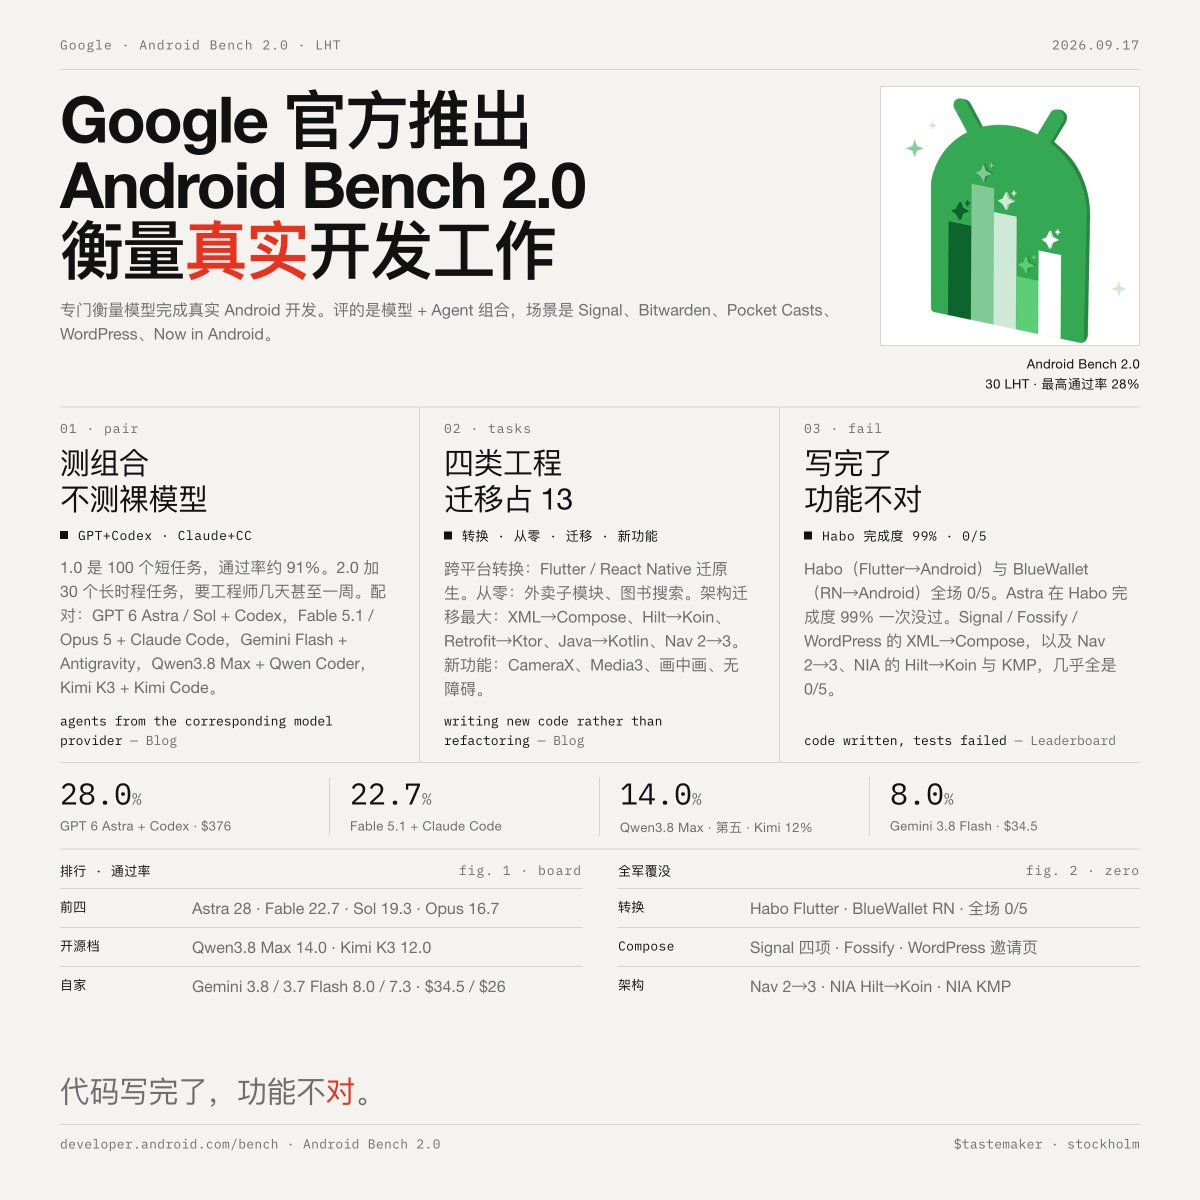
Databricks は GPT-6 Astra を 3,500 人のエンジニアに導入し、コーディング支出が 60% 増加したことを確認した。同モデルの効果は複雑なタスクに集中しており、単純なタスクでは顕著な改善は見られなかった。Android Bench 2.0 では GPT-6 Astra + Codex がトップとなったが、クロスプラットフォーム移行タスクでは全モデルが失敗した。
Key insights
Databricks 導入に関する所見
Databricks の共同創業者 @pwendell 氏は、GPT-6 Astra の全面導入から得られた5つの重要な所見を共有した。同モデルはシステム設計や長期タスクなどの高複雑度タスクにおいて、従来のフラッグシップモデル(Opus 5、Sol 5.6)を明らかに上回る性能を示したが、中・低複雑度タスクでは飽和状態とされ、顕著な改善は見られなかった。コーディング支出全体は60%増加したが、これはモデルの品質向上による利用増加と解釈されている。
Android Bench 2.0 の結果
Google は Android Bench 2.0 を公開し、モデルとエージェントの組み合わせを実際の Android 開発タスクでテストした。GPT-6 Astra + Codex と Claude Fable 5.1 + Claude Code が上位2位を占めた。ベンチマークは、アプリ変換、ゼロからの構築、アーキテクチャ移行、新機能開発の30タスクで構成される。全モデルはクロスプラットフォーム変換タスク(Flutter→Android、React Native→Android)と、ほとんどの XML→Compose 移行で0/5 のスコアだった。
自律ロボティクスタスク
あるユーザーが GPT-6 Astra に単一のプロンプトを与え、Isaac RL と Sharpa ハンドを使用して器用なハンドにペン回しタスクを学習させた。モデルは自律的に1.5日間動作し、ポリシーの学習と可視化動画の生成を含め、エンドツーエンドの自律研究能力を示した。
コスト管理と予算ルーティング
Databricks はモデル選択を誘導するための予算メカニズムを導入した。Astra 専用の個別サブ予算を設定し、複雑なタスクには Astra を、日常業務にはより安価なモデルを使うようエンジニアに促している。この予算は価格設定とインセンティブのためのツールであり、厳格な上限ではなく、レビューを通じて調整可能である。このアプローチはモデルルーティングをリソース配分の問題に変換するものである。
データコンプライアンスが採用障壁に
Databricks は Astra と Fable 5.1 を比較できなかった。なぜなら、Fable のデータ保持ポリシーが同社の要件を満たさなかったためである。このことは、エンタープライズにおけるモデル選定では、性能よりもデータコンプライアンスが最初のハードルとなることが多いことを浮き彫りにしている。
ゲートウェイとキュー方式による段階的展開
Databricks は Unity Gateway を内部 LLM ゲートウェイとして使用し、キュー方式の実験を実施した。200人規模のパイロットで品質とコストのシグナルを収集した後、3,500人のエンジニアに拡大した。これは、新しいモデルをフィーチャーフラグのように実験的に導入するガバナンスパラダイムを示している。