
Hugging Face tokenizers v1 リリース、エンコード速度を向上
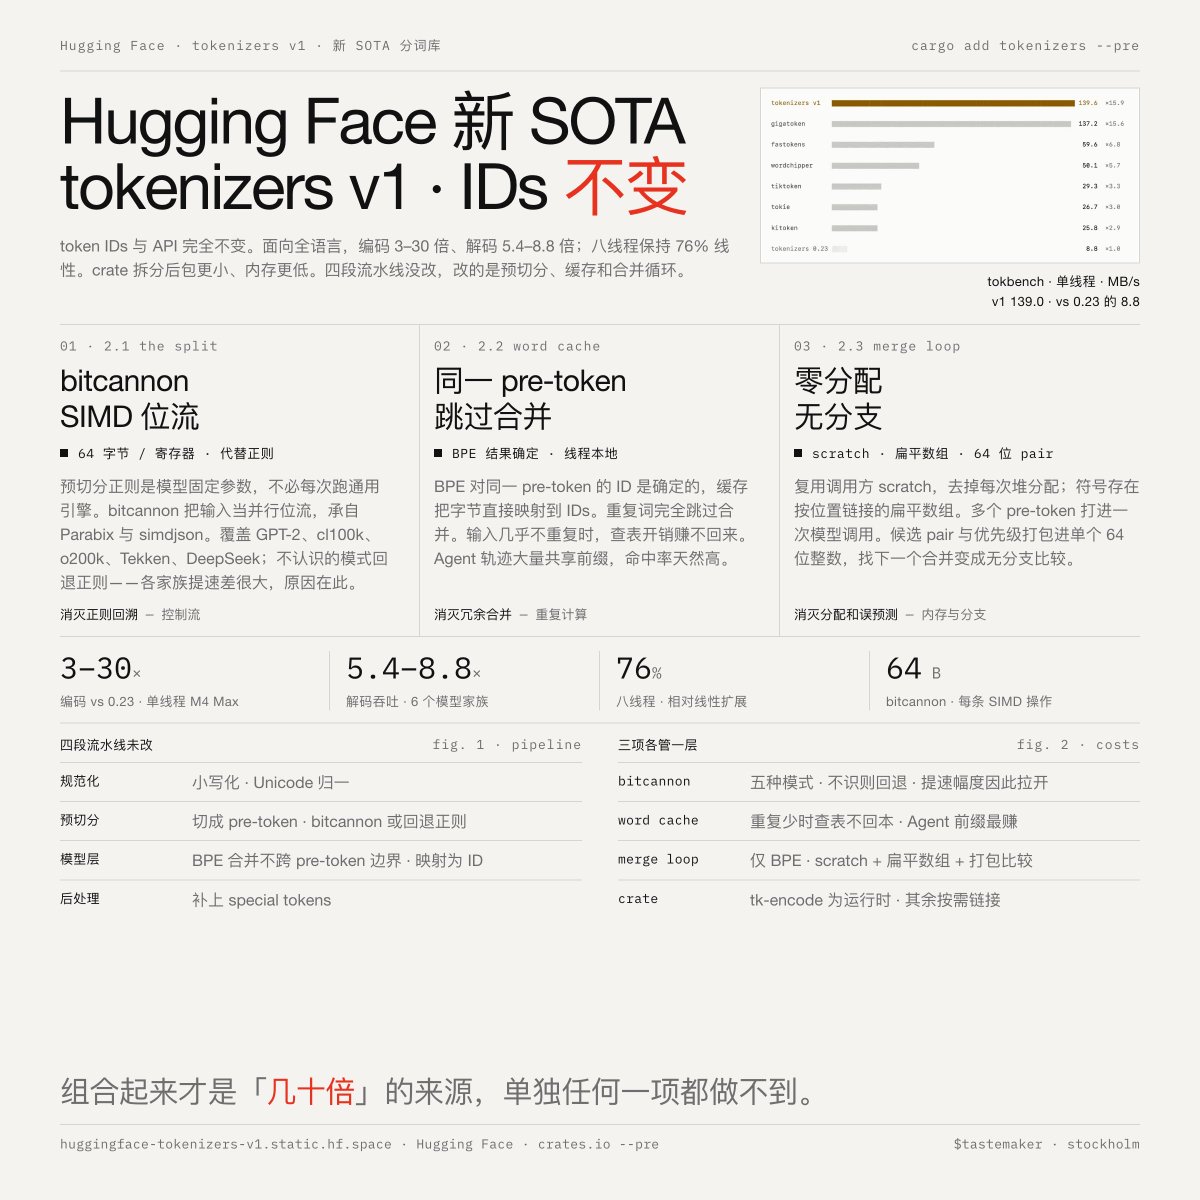
Hugging Faceは、オープンソースライブラリtokenizers v1をリリースした。このライブラリは、APIの変更なしに全言語でエンコード速度を3~30倍、デコード速度を5.4~8.8倍に高速化する。SIMDビットストリーム事前トークン化、スレッドローカルワードキャッシュ、ゼロアロケーションマージループを採用している。
Key insights
API変更なしで全言語でパフォーマンス向上
Tokenizers v1は、トークンIDとAPIの完全な後方互換性を維持しながら、全言語でエンコードを3~30倍、デコードを5.4~8.8倍高速化する。この改善は、4段階パイプラインへのアルゴリズム変更ではなく、ハードウェアを考慮した最適化によって達成されている。
ビットキャノン:SIMDビットストリームが正規表現エンジンを置換
ビットキャノン技術は、入力バイトをSIMDレジスタで処理される並列ビットストリームとして扱い、1操作あたり64バイトを処理する。GPT-2、cl100k、o200k、Tekken、DeepSeekの5つの分割モードに対応し、未知のパターンに対しては正規表現にフォールバックする。これにより、トークナイザーファミリー間の速度差が説明される。
ワードキャッシュが冗長なBPEマージを排除
スレッドローカルキャッシュは、BPEの決定論的性質を活用して、事前トークンバイトをトークンIDにマッピングする。繰り返し出現する単語はマージ計算を完全にスキップする。このキャッシュは、多くのリクエストが共通のプレフィックスを共有するエージェントシナリオで特に効果的であり、ヒット率を向上させる。
マージループがゼロアロケーションと分岐なし実行を実現
マージループは、呼び出し元が提供するスクラッチバッファ、リンクされたフラット配列、バッチ化されたモデル呼び出し、および優先順位付きの候補ペアを64ビット整数にパッキングして分岐なし比較を行う、という4つの技術を使用する。これにより、ヒープ割り当てが排除され、メモリオーバーヘッドが削減され、分岐予測ミスが回避される。
組み合わせた最適化が3つのコスト層を対象
各技術は異なるコスト層に対処する。ビットキャノンは制御フロー(正規表現のバックトラッキング)を排除し、ワードキャッシュは冗長な計算を除去し、マージループは割り当てと分岐予測失敗を排除する。これらの組み合わせ効果により、報告されている3~30倍の高速化が達成される。単一の技術だけではその効果は得られない。