
Hugging Face、大幅な高速化を実現したtokenizers v1をリリース
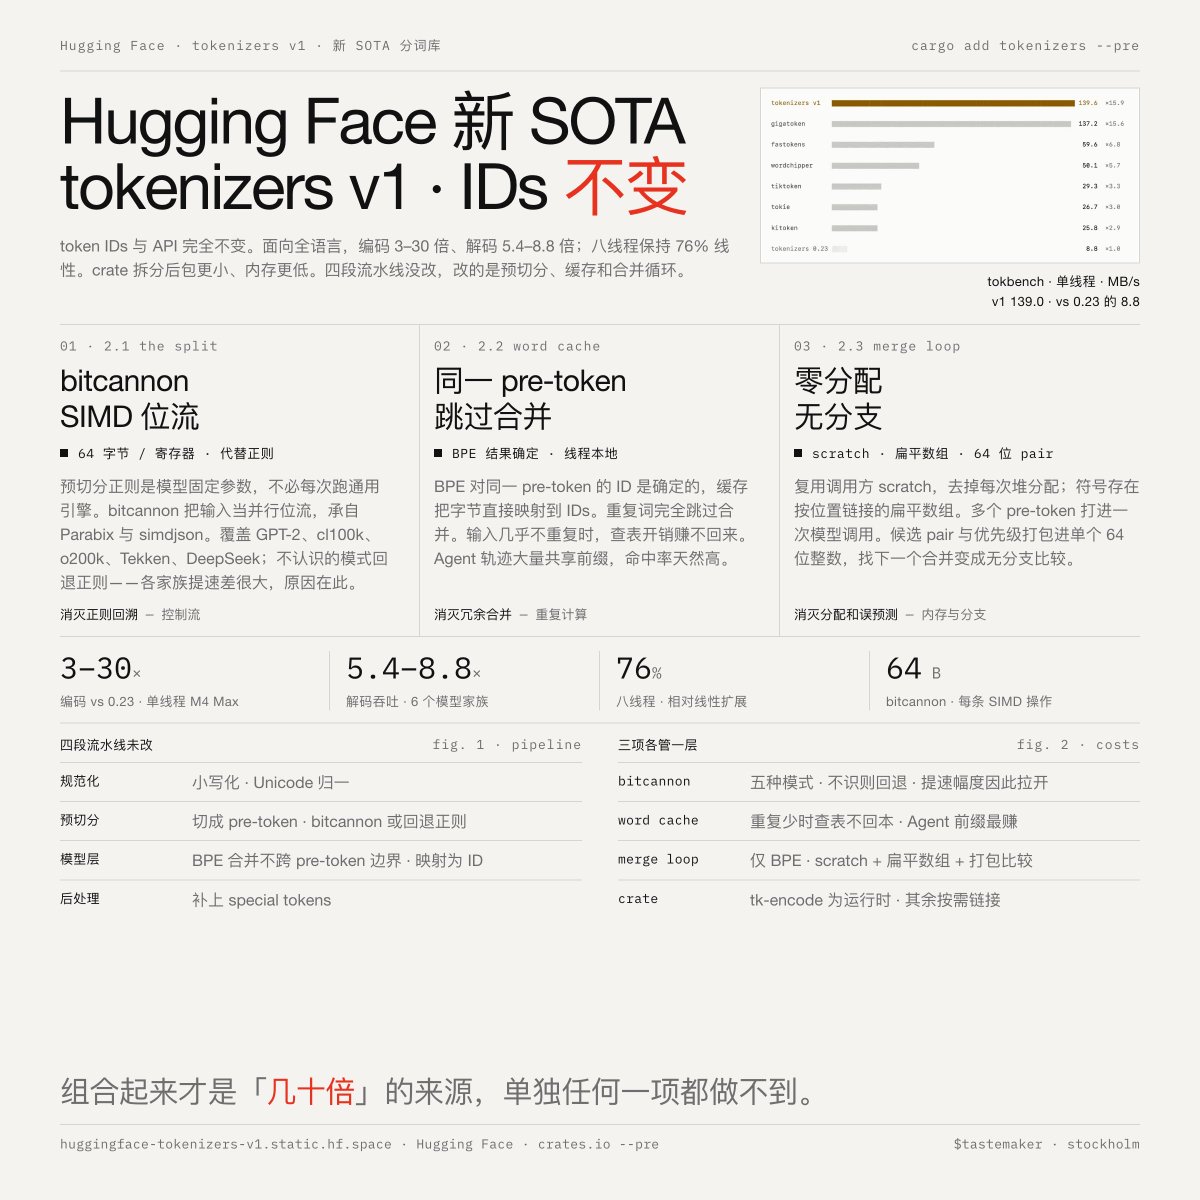
Hugging Faceは、新しいトークン化ライブラリであるtokenizers v1をリリースしました。このライブラリは、APIを変更することなく、全言語でエンコーディングを3〜30倍、デコーディングを5.4〜8.8倍高速化します。速度向上は、SIMDベースのビットカノン、繰り返しトークンのワードキャッシュ、ゼロ割り当てマージループの3つの中核技術に由来します。
Key insights
ビットカノンが正規表現をSIMDビットストリームに置き換え
ビットカノン技術は、入力バイトをSIMDレジスタを介して処理される並列ビットストリームとして扱い、事前トークン化中の汎用正規表現エンジンを不要にします。これにより、5つのトークン化モード(GPT-2、cl100k、o200k、Tekken、DeepSeek)をカバーし、認識されないパターンに対しては正規表現にフォールバックするため、モデルファミリーごとの速度向上の差が説明されます。
ワードキャッシュが冗長なBPEマージを排除
スレッドローカルなワードキャッシュは、事前トークンのバイトをトークンIDにマッピングし、繰り返される単語のマージ計算をスキップします。これは、多くのリクエストが共通のプレフィックスを共有するエージェントシナリオで特に効果的で、キャッシュヒット率が高くなります。キャッシュルックアップのオーバーヘッドは、繰り返しが頻繁な場合にのみ正当化されます。
マージループがゼロ割り当てと分岐なし実行を実現
マージループの最適化は、呼び出し元が提供するスクラッチバッファの再利用、シンボルを位置でリンクされたフラット配列に格納、複数の事前トークンを単一のモデル呼び出しにバッチ処理、各候補ペアをマージ優先度とともに64ビット整数にパックするという4つの技術を組み合わせます。これにより、ヒープ割り当て、リンクリストのオーバーヘッド、分岐予測ミスが排除されます。
3つの技術が異なるボトルネックをターゲットに
3つの中核技術は、ビットカノンが正規表現のバックトラッキング(制御フロー)を排除し、ワードキャッシュが冗長なマージ(繰り返し計算)を排除し、マージループが割り当てと分岐予測の失敗(メモリと分岐)を削減するという、異なるコスト層に対処します。これらの組み合わせにより、報告されている3〜30倍の高速化が達成されますが、単一の技術だけではその効果は得られません。