
HuggingFace、大幅な速度向上を実現したtokenizers v1をリリース
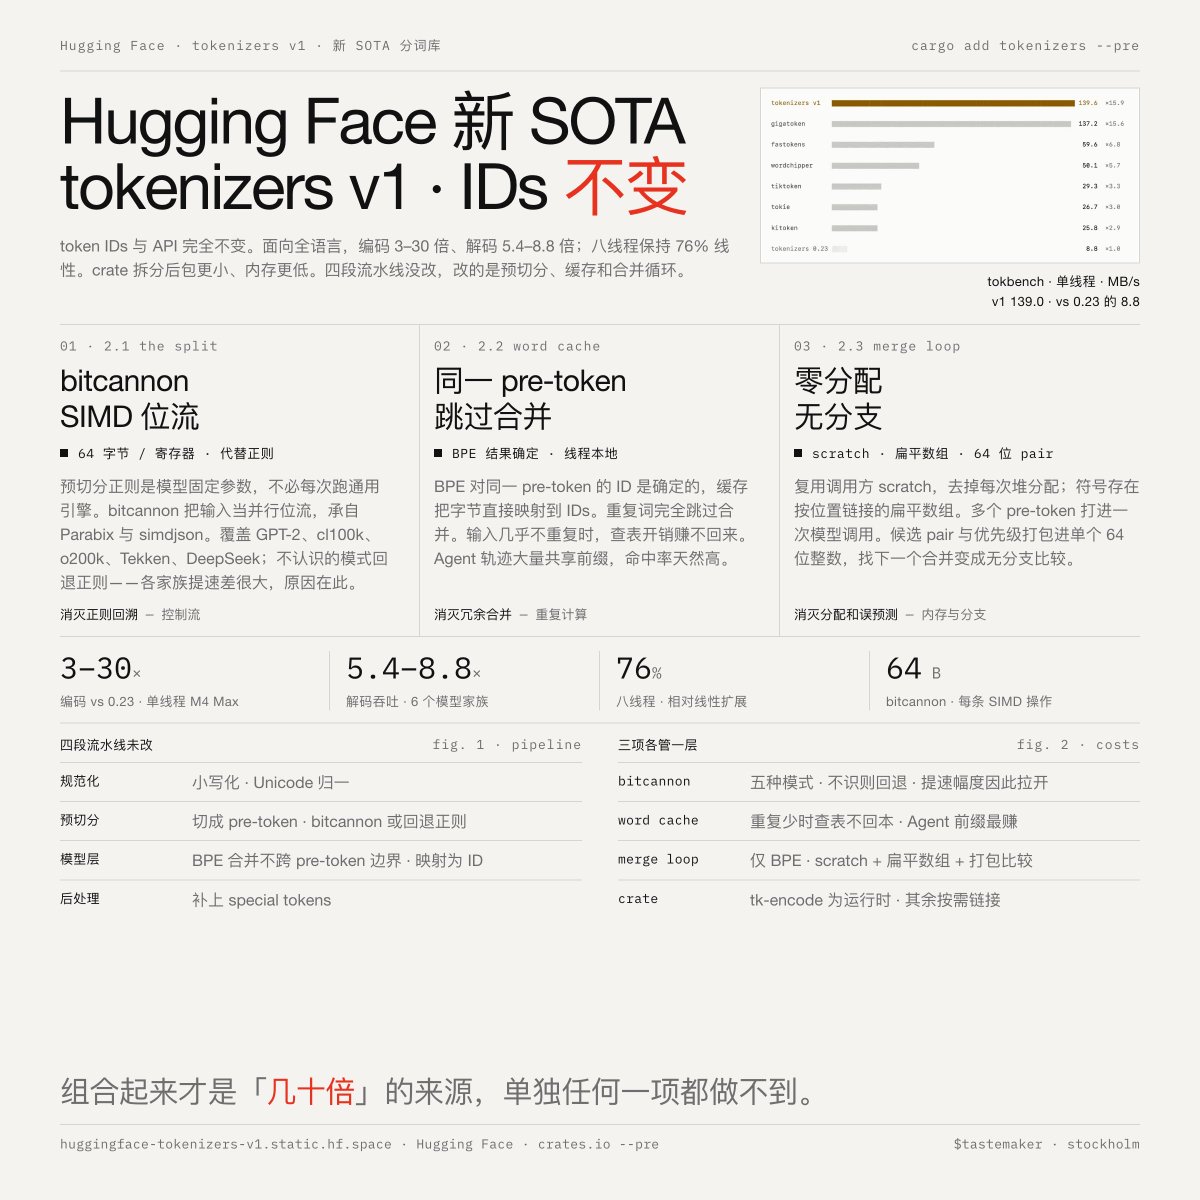
HuggingFaceは、トークン化ライブラリのメジャーアップデートとなるtokenizers v1をリリースした。SIMDベースの分割、単語キャッシュ、ゼロアロケーションのマージを活用し、エンコード速度を3~30倍、デコード速度を5.4~8.8倍に向上。メモリ使用量は2.8倍削減され、同一のトークンIDとAPIを維持し後方互換性を持つ。
Key insights
パフォーマンス向上を実現する3つの主要技術
Tokenizers v1は、3つの主要な最適化を採用している。Bitcannonは正規表現をSIMDビットストリーム処理に置き換えて事前トークン化を行い、5つの分割モード(GPT-2、cl100k、o200k、Tekken、DeepSeek)に対応し、未知のモードでは正規表現にフォールバックする。Word cacheは、スレッドローカルストレージ内の事前トークンごとにBPEマージ結果をキャッシュし、プレフィックス再利用が多いエージェントトレースに有効。Merge loopは、優先順位を単一の64ビット整数にパックし、スクラッチバッファを再利用することで、ゼロアロケーションかつ分岐なしのマージを実現する。
言語別のパフォーマンス測定結果
シングルスレッドテストにおいて、tokenizers v1は従来の0.23バージョンと比較して3~30倍高速化された。512バイトの英語文書では、レイテンシが110マイクロ秒から7マイクロ秒に低下。中国語のスループットは6.8倍向上し、ヒンディー語とアムハラ語では10倍以上の改善が見られた。デコード速度は5.4~8.8倍向上。メモリ使用量は2.8倍削減された。
後方互換性とパッケージサイズの削減
Tokenizers v1は、0.23バージョンと同一のトークンIDおよびAPIを維持し、完全な後方互換性を持つ。ライブラリはRustで記述され、PythonおよびNode.jsバインディングを提供。推論モジュールと訓練モジュールは別々のクレートに分割され、推論のみ必要な場合のインストールサイズを削減する。2008年以降のx86 CPUで動作し、Apple ARMチップ向けの特定の最適化も含まれている。
ワードキャッシュがエージェントおよび長文脈シナリオに有効
ワードキャッシュの最適化は、多くのリクエストが同じプレフィックスを共有するエージェントワークロードで特に効果的である。このようなシナリオではキャッシュヒット率が自然に高く、冗長なマージ計算が削減される。入力の繰り返しが少ない場合のコストは無視できる程度であり、BPEマージステップに比べてルックアップのオーバーヘッドは最小限である。