
LLMのための検索とメモリのプリミティブ
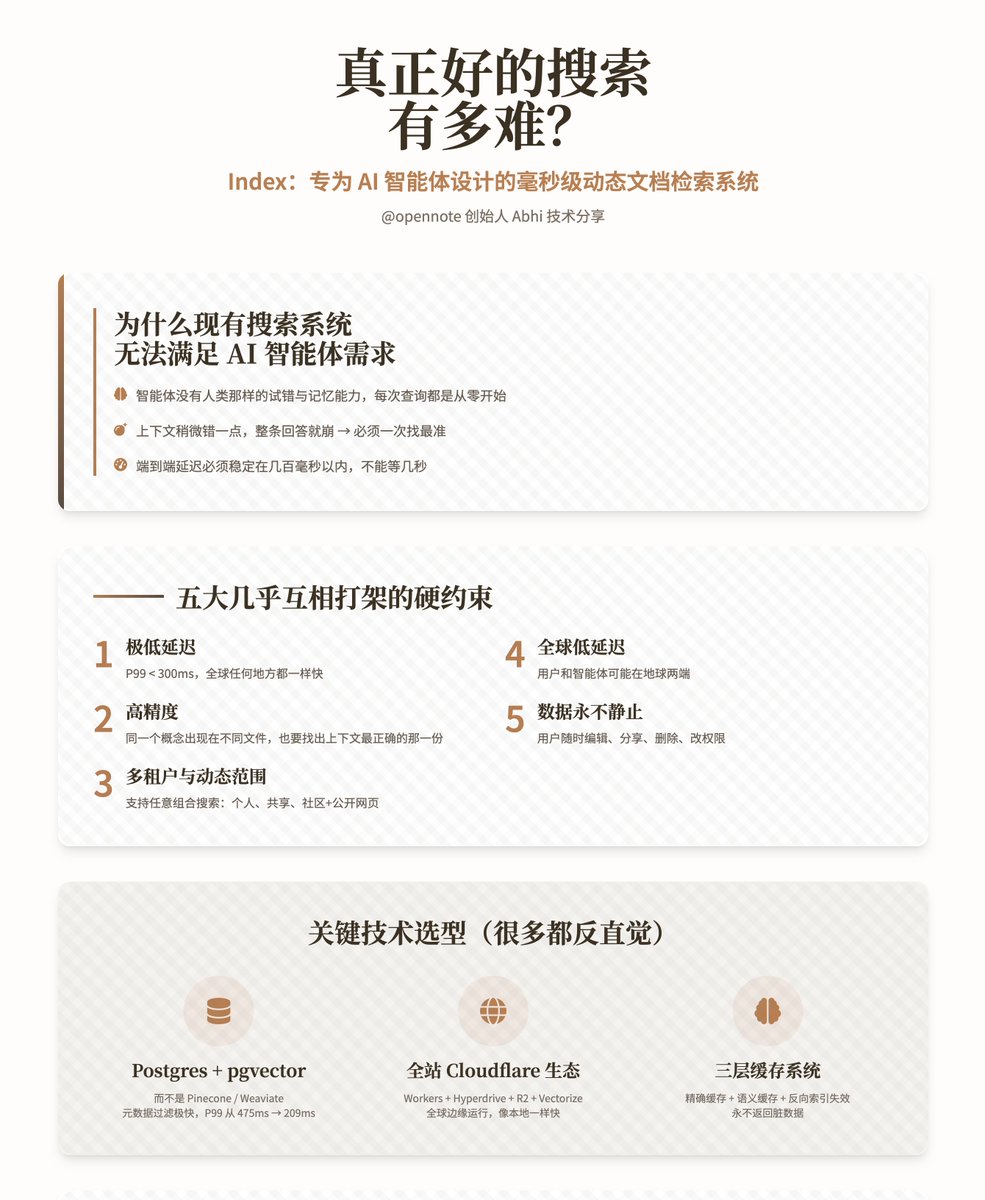
新しい検索およびメモリシステムは、ミリ秒レベルの高精度エージェント検索と持続的なLLMメモリを目指しています。
Key insights
オープンノートのインデックスはエージェントのためのミリ秒動的検索を目指す
オープンノートは、P99 <300msのレイテンシーでAIエージェント向けに最適化された検索システム「インデックス」を説明しました。インデックスは、専用のベクトルデータベースの上にPostgres(pgvector/pg_trgm/tsvector)を使用し、効率的なメタデータの事前フィルタリング、混合キーワード/ベクトル検索、マルチテナントの動的フィルター、およびCloudflare Workersを介したエッジ分散ランタイムを実現しています。取り込みパイプラインは、変更された埋め込みのみを再計算するためにチャンクをハッシュし、三層のキャッシュと正確な無効化を統合して新鮮さを保証します。
メモリはLLMとエージェントのためのSQLネイティブなオープンメモリプリミティブを提供
メモリは、標準のSQLデータベースと統合され、LLMのための持続的でクエリ可能なメモリを提供するオープンメモリエンジンです。LLMの呼び出しをインターセプトして短期メモリを注入し、応答後にエンティティと事実を抽出し、定期的な「意識」ジョブを実行して長期メモリを抽出し、意識的/自動/統合メモリモードをサポートし、ワンライン統合を実現します。
ハイブリッド設計はメタデータ、ベクトル融合、操作制御にSQLを好む
両システムは、メタデータフィルタリング、操作セマンティクス(UPSERT/DELETE)、マルチテナントの隔離、正確なキャッシュ無効化にSQLプリミティブを好み、これらの特性が多くのベクトルストアよりも優れたレイテンシー、一貫性、および動的フィルタリングを提供すると主張しています。