
LLMの理解と思考過程のモニタリング
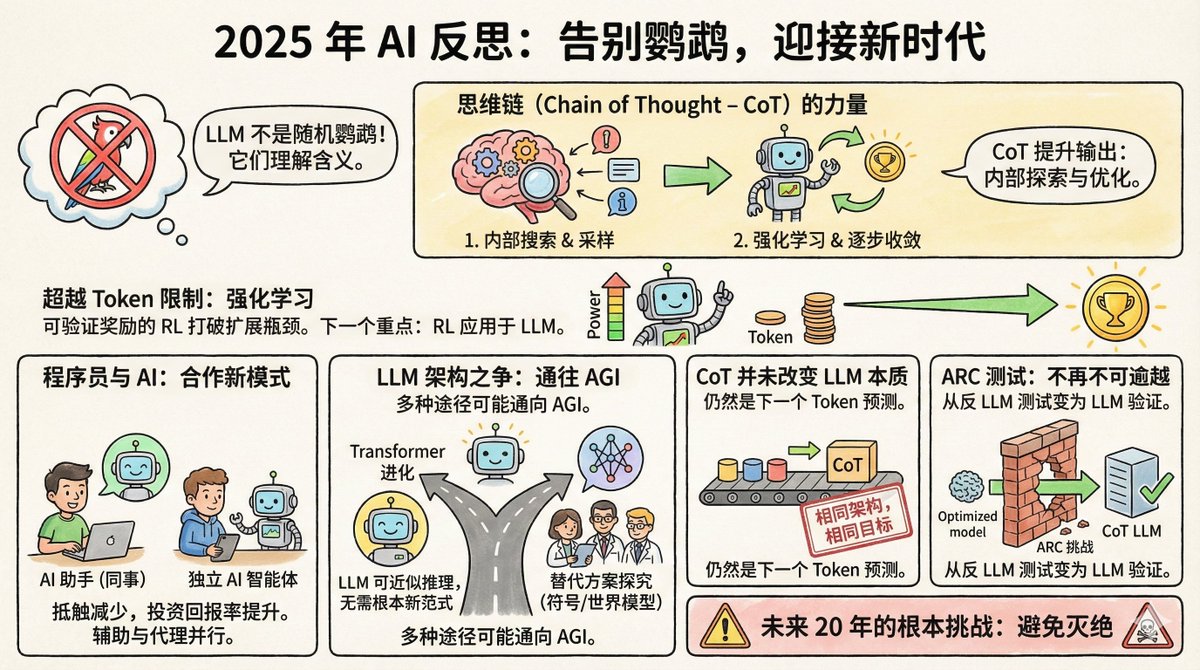
二つの分析は、LLMが内部概念表現を形成していること、そして思考過程(CoT)モニタリングが測定可能な安全ツールであることを主張しています。
Key insights
LLMは単なる確率的オウム以上の存在である
サルバトーレ・サンフィリッポは、2025年までに「確率的オウム」という批判がほぼ消え去ると報告しています。実証的証拠には、LLMのパフォーマンスが法律、医学、数学の試験でほとんどの人間を超えていることや、逆エンジニアリングによって内部概念表現が示されていることが含まれます。彼は、次のトークンを予測するには文レベルの理解が必要であるというジェフリー・ヒントンの主張を引用しています。サンフィリッポは、モデルの理解を単純に否定することの実用的な終焉としてこれを位置づけつつ、哲学的な論争が残っていることに言及しています。
思考過程は過小評価されたブレークスルーである
サンフィリッポは、思考過程(CoT)プロンプトが内部表現を回答前に露出させることでモデルの行動を変えると主張し、強化学習と組み合わせることでモデルを信頼性のある多段階解決に導くと説明しています。彼は、CoTがモデルに関連する概念をサンプリングし、前面に出すよう促すことで機能し(「スクラッチペーパーにアウトラインを書く」)、トークンごとのRLが生成を収束的な推論経路に導くことを説明しています。
OpenAI: CoTモニタリングは安全性を向上させる
OpenAIの研究は、CoTモニタリング可能性フレームワークと、内部推論が外部モニタリング可能性を高めることを示す13の評価方法を提示しています。発見には「モニタリング可能性税」のトレードオフが含まれています。つまり、長い推論を持つ小さなモデルは、はるかに大きな浅いモデルよりも監視が容易であり、ターゲットを絞ったフォローアップ質問がより明確な内部推論を引き出すことができるということです。この論文は、現在のスケールでは、RLがCoTの透明性を測定可能に低下させていないと報告しています。
計算と自己教師ありRLがトレーニング信号を拡大する
サンフィリッポは、検証可能な報酬タスク(例:プログラム最適化、定理証明)がほぼ無限のトレーニング信号を提供し、人間のテキストの限界を超えた能力の成長を可能にすると指摘しています。彼は、これを推論のRL駆動の改善に関連付け、進展のためにトランスフォーマーを放棄する必要はないと示唆しています。