
LLMインフラストラクチャ:検索、メモリ、プロンプト転送と評価
エンジニアたちは、エージェントと生産用LLMをサポートするために、検索、メモリ、プロンプトの移植性に関するツールとガイドを発表しました。
Key insights
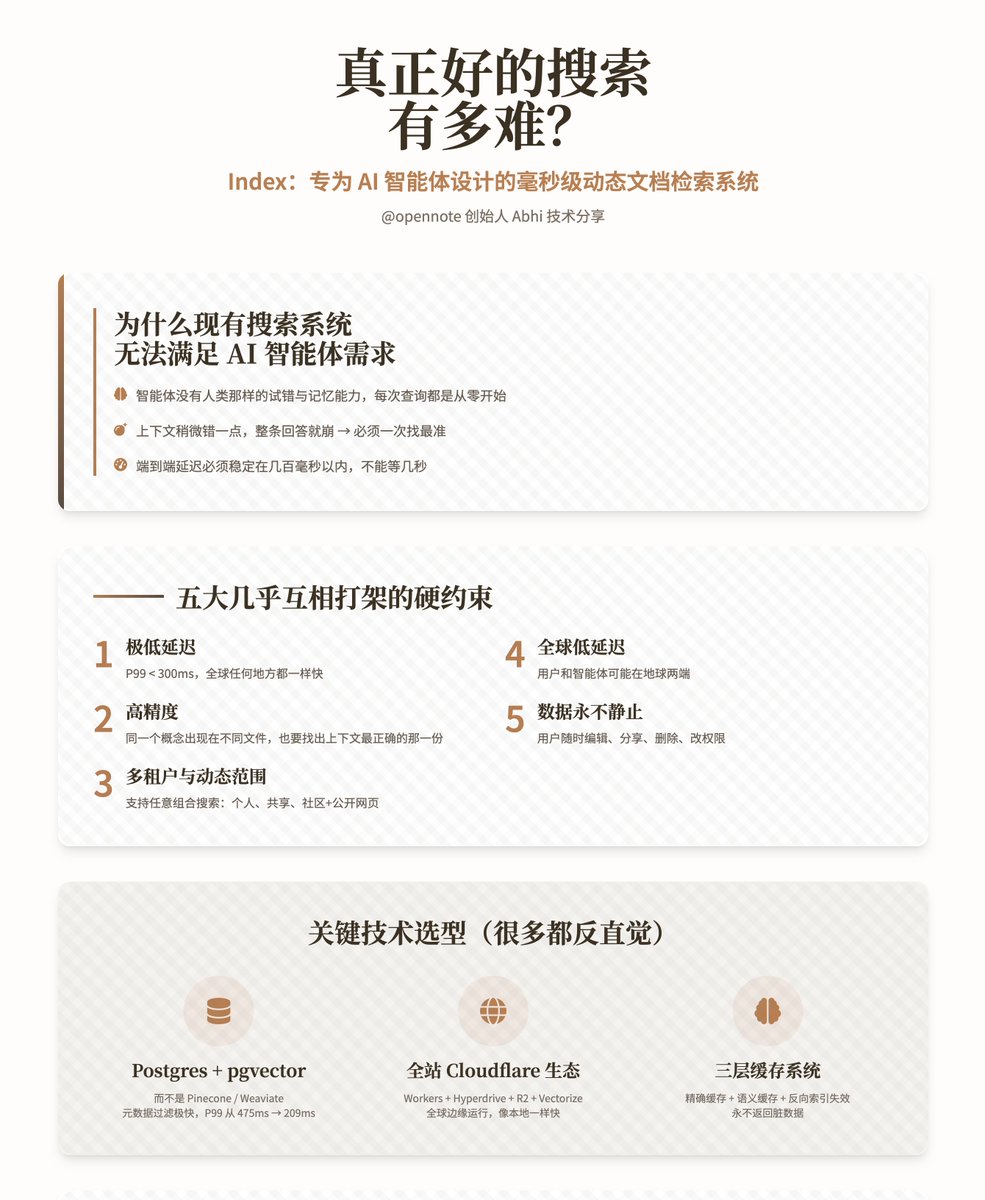
インデックスは生産検索がレイテンシ、メタデータフィルタリング、動的更新を優先することを示す
Opennoteのインデックスエンジンは、厳しいレイテンシと精度の制約を持つエージェントのユースケースに最適化されています。Postgres(pgvector+pg_trgm+tsvector)を使用してメタデータフィルタリングを行い、Cloudflareのグローバルエッジ上で実行され、P99を300ms未満に保つために三層キャッシュとチャンクハッシュを実装しています。この設計選択は、小規模から中規模の文書セットに対する迅速で正確な検索と、オフ・ザ・シェルフのベクトルDBに対する動的な権限付与を優先しています。
MemoriはSQLネイティブで監査可能なメモリを提供し、マルチモード操作を実現
Memoriは、多くのLLMと統合するオープンなSQLネイティブメモリエンジンで、永続的でクエリ可能なメモリを提供します。エンティティを抽出し、意識的および自動モードを維持し、定期的なバックグラウンド蒸留を実行し、単一のAPIコールを介して簡単に統合できることを強調しています。このプロジェクトは、監査可能なストレージを重視し、フィルタリングと動的更新のためにSQL機能を活用しています。
PromptBridgeはモデル間のプロンプト移行コストを削減
PromptBridgeは、2つのモデル間でペアの最適なプロンプトを収集するキャリブレーションステップを導入し、LLMを再訓練することなく、ソースからターゲットモデルへのプロンプトを翻訳するマッピングを学習します。このアプローチは、プロバイダー間でアプリケーションを移行する際の手動プロンプト再設計を最小限に抑え、多エージェントおよび単一エージェントシナリオで評価されました。
PagedAttentionを用いたプロンプトキャッシングが大規模な推論コスト削減を実現
PagedAttentionベースのプロンプトキャッシングは、コンテンツベースのハッシュされたKVブロックを利用して、ユーザー間でのグローバルキャッシュの再利用を実現します。ベストプラクティスには、安定したプレフィックス、決定論的シリアル化、追加のみの履歴が含まれます。適切に使用すれば、キャッシングはプレフィル計算を最大10倍削減し、高い同時実行シナリオにおける最初のトークンのレイテンシを劇的に低下させます。
コミュニティリソースと評価基準が成熟している
Hugging Faceは、15,000以上のモデルと3年間のデータを統合した「LLM評価ガイドブック」を公開し、実務者がベンチマークの落とし穴を避ける手助けをしています。Smart Turn v3.1のようなオープンプロジェクトは、スピーチターン検出とローカルキャプショニングを改善し、マルチモーダルなリアルタイムユースケースのためのツールの進展を示しています。