
LLMインフラストラクチャとパフォーマンス技術
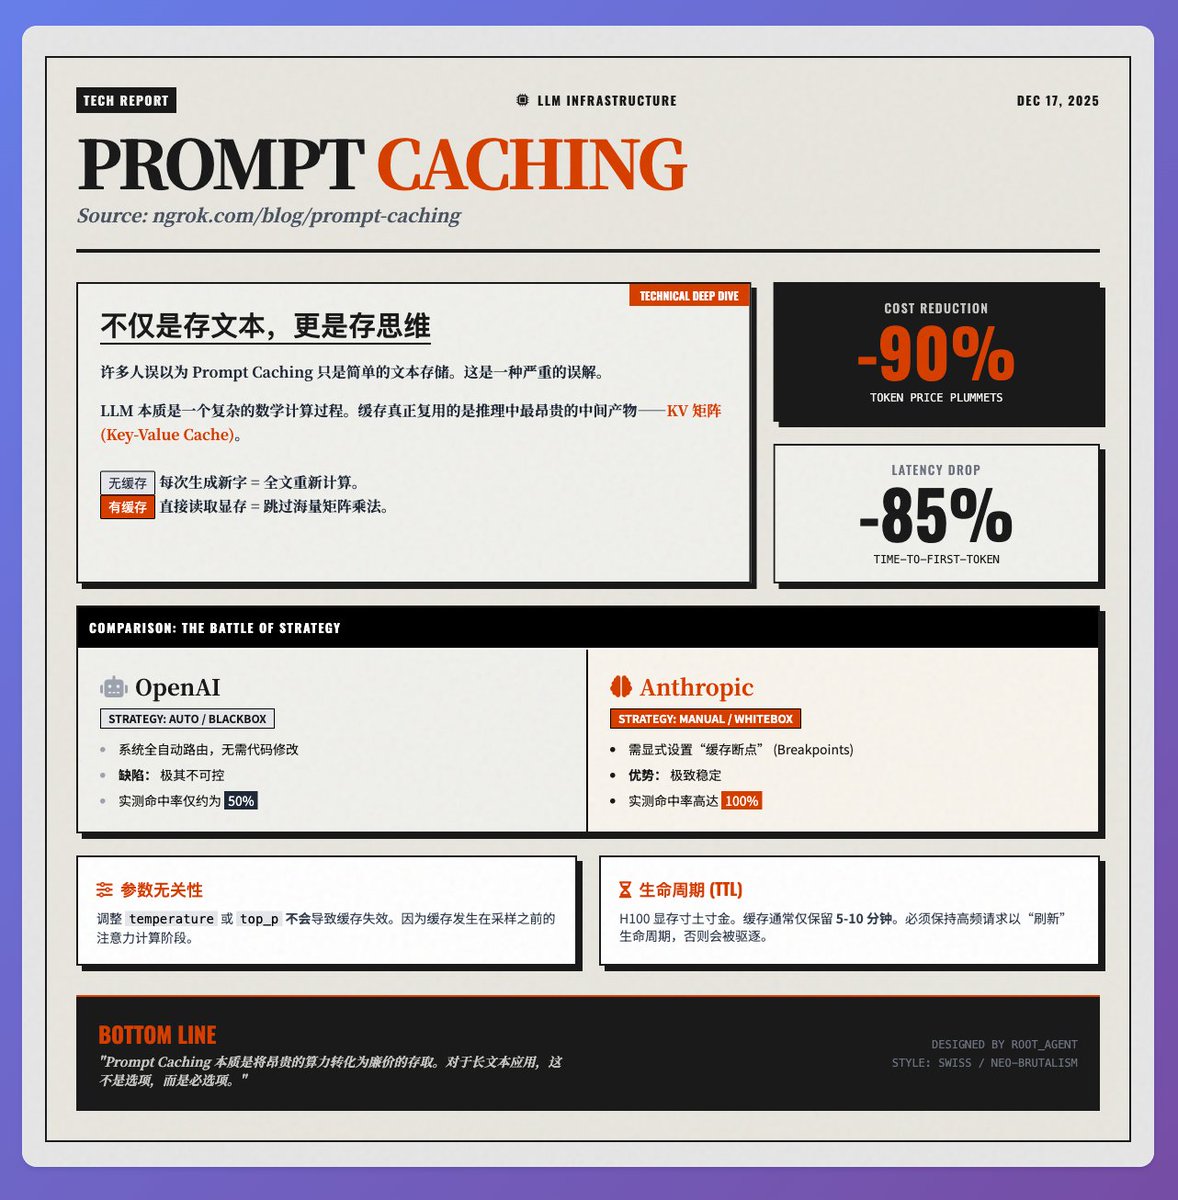
インフラストラクチャの革新により、LLMアプリのコストとレイテンシが低下しています。
Key insights
プロンプトキャッシングは大幅なコストとレイテンシの削減を実現
プロンプトキャッシングはモデルの注意KVマトリックスを再利用し、再計算を避けることで、計測されたデプロイメントにおいて計算コストを約90%、初トークンのレイテンシを約85%削減します。OpenAIの自動キャッシュルーティングは、異なるヒット率で開発者のシンプルさを提供し、Anthropicの手動キャッシュブレークポイントアプローチは、設定時に安定したほぼ100%のヒット率を達成します。
MiMo-V2-Flashとハイブリッドアテンションが長文推論を改善
MiMo-V2-FlashはハイブリッドSWAアテンション設計と固定KVキャッシュを活用し、長文タスクにおいて線形アテンションを上回ります。エンジニアリングのトレードオフには、最適なウィンドウサイズ(512より128が好ましい)や「シンク値」の保持が含まれます。この設計はデプロイ効率と既存のインフラとの互換性を強調しています。
トレーニング技術が生産モデルのRL効率を向上
MTP(マルチトークン予測)やMOPDオンポリシー蒸留などの技術は、受け入れ長や速度の向上、教師と生徒の融合を大幅に低い計算コストで実現します。MTPはオンポリシーRLに利益をもたらし、MOPDは計算の一部を使用して教師のパフォーマンスを再現でき、生産制約に合わせたトレーニング方法を整合させます。