
LLMトレーニング後の学習継続に関する研究(ネスト学習/記憶スペクトル)
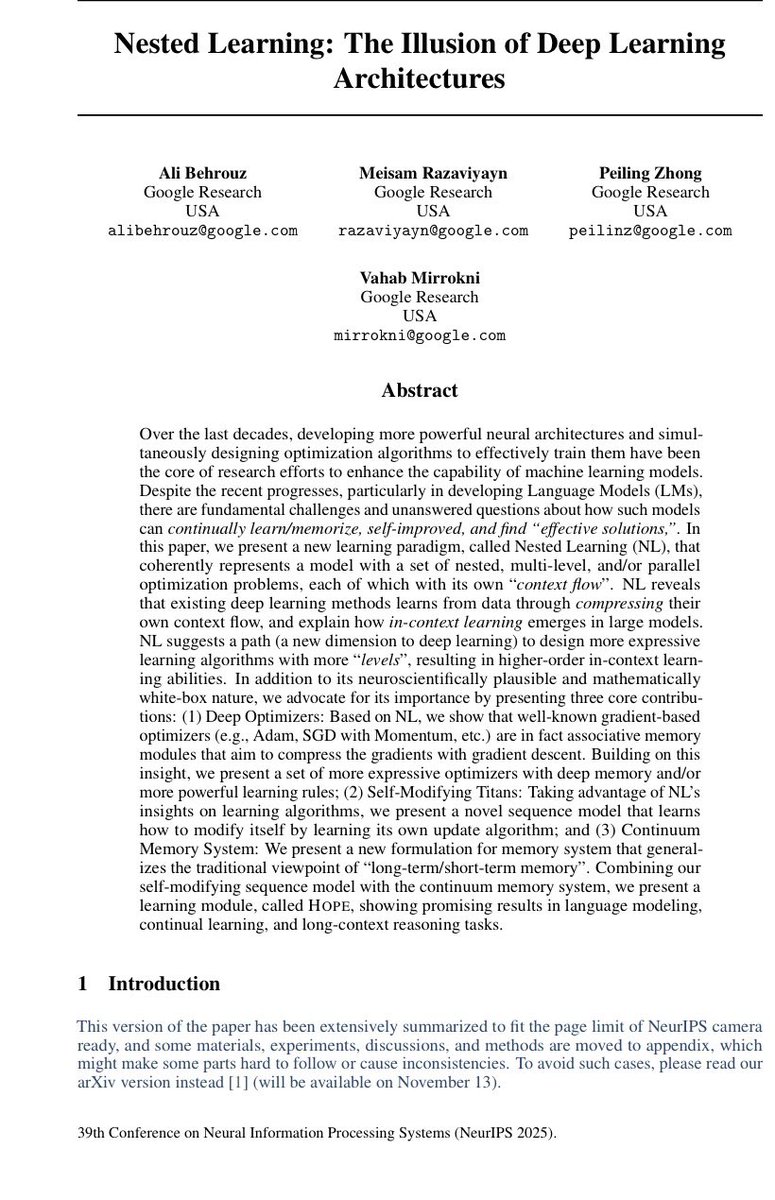
Googleは「ネスト学習」プランを提案し、大型言語モデルのトレーニング後に学習を続けられない問題を説明し解決します。
Key insights
Googleの論文がLLMトレーニング後の学習継続の問題を診断
Googleは新しい論文で、現在の主流の大型言語モデルが一般的に「トレーニング後に学習を続けられない」問題を抱えていることを明らかにしました。論文では、これらのモデルが即時の対話内容や遠くの事前トレーニングデータにアクセスできる一方で、新しい情報を長期記憶に統合するメカニズムが欠如していることを指摘しています。この現象は「デジタル健忘症」と呼ばれ、ChatGPTやGeminiなどの既存システムの限界に直接的に言及しています。
ネスト学習:連続記憶スペクトルの解決策
論文は「ネスト学習」(nested learning)プランを提案し、従来の速/遅の記憶二分構造の代わりに、連続した記憶スペクトルを用いることを主張しています。このプランは、異なる速度で動作する複数の学習プロセスを構築することを提案し、モデルに迅速、中程度、遅延などの多層記憶(例:朝食/先月/子供時代の類比)を持たせることを目指しています。ネスト学習は、情報が中期的に徐々に固化されることを可能にし、現在のLLMが新しい情報を長期記憶に転送できない欠陥を補います。
論文が強調する設計の重要な次元:時間と更新頻度
論文は、過去のAI構築が主に「より大規模な知識階層/記憶容量」に焦点を当てていたが、もう一つの完全な次元、すなわち「時間と更新頻度」を無視していたことを指摘しています。研究者は、モデルの規模を拡大するだけでなく、設計時に記憶更新の時間スケールと頻度を考慮する必要があると提案し、即時の相互作用から長期的な知識へのスムーズな移行と定着を支援することが重要であると述べています。
LLMの現在の記憶構造が引き起こす「デジタル健忘症」
複数の投稿がまとめたところによると、現在の大型言語モデルは超高速の短期記憶(現在の対話)と凍結された長期記憶(事前トレーニング)を持つ一方で、中間スペクトルの記憶定着プロセスが欠けています。このため、モデルは即時に文脈や過去のトレーニングデータを引用できるものの、新しい相互作用経験を持続可能な長期知識に統合することができず、いわゆる「デジタル健忘症」を形成しています。
関連実践と歴史的な取り組みが先行証拠として引用される
投稿では、以前のDeepseekが画像圧縮記憶を使用した事例が言及され、記憶の有効性に対する考慮からも出発していることが示されています。これはネスト学習の考え方に関連する実践的な参考として位置づけられています。同時に、Googleがこのプランを成功させることに対する信頼感を示す投稿もあります。論文の提案は、AIが使用中に持続的に改善されることを可能にし、単にリリース前のトレーニング段階に限られないと考えられています。