
LLM強化学習を安定化させるスコアセンタリング手法が提案される
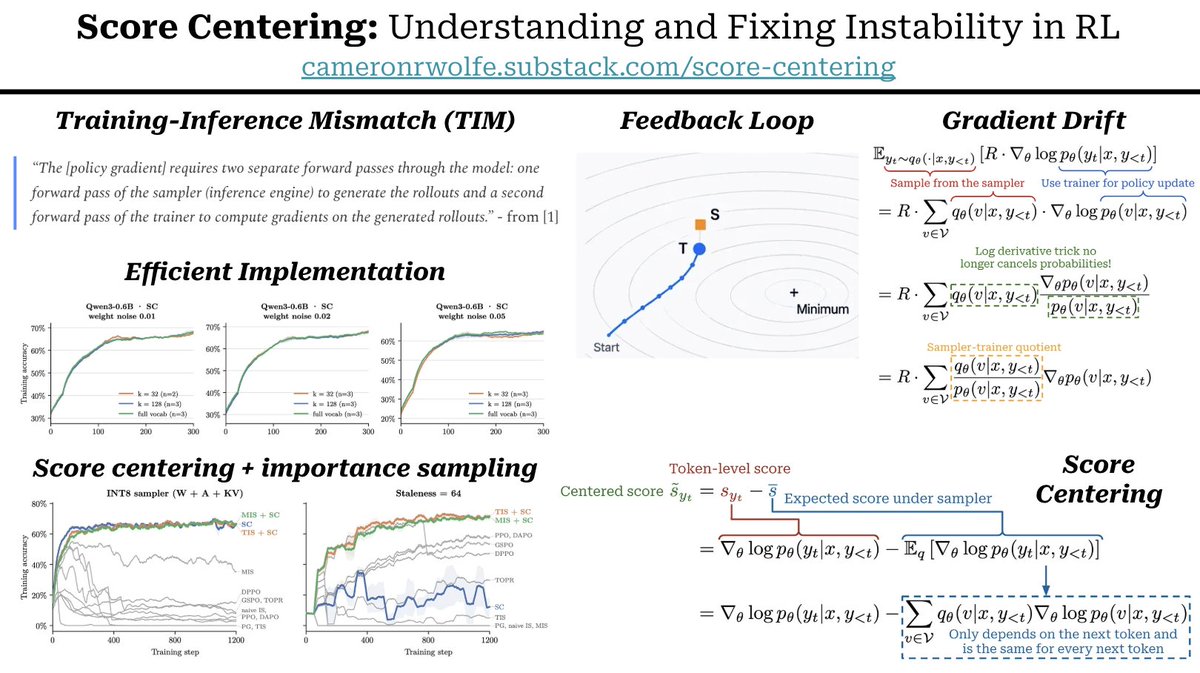
スコアセンタリングに関する詳細な分析が公開され、訓練と推論の不一致下でLLM強化学習が不安定になる理由を説明し、方策勾配に対する加法的補正を提案している。この手法は、各サンプリングされたトークンのスコアからサンプラーの期待トークンスコアを減算するもので、サンプラーのtop-kトークン確率のみを用いて近似できる。著者らは、スコアセンタリングを切り捨てまたはマスク付き重要度サンプリングと組み合わせることで最高の性能がしばしば達成されることを示している。
イベントのバージョン 1.
Key insights
訓練と推論の不一致が不安定性を引き起こす
現代のRLインフラストラクチャは、ロールアウト生成と方策更新をサンプラーエンジンとトレーナーエンジンに分離している。数値精度、量子化、異なるGPUカーネル、および古いロールアウトを用いた非同期訓練により、2つのエンジン間でトークン確率が異なり、方策勾配更新に系統的なバイアスが導入される。
勾配ドリフトが偽の学習信号を生み出す
訓練と推論の不一致下では、一定報酬の設定でも非ゼロの期待方策勾配が生じ、これは勾配ドリフトと呼ばれる偽の学習信号である。このドリフトは、報酬信号に関係なくトレーナーをサンプラーに向かって押し進める。
フィードバックループが誤差を蓄積する
オンラインRLはトレーナーからサンプラーを更新し、フィードバックループを形成する。トレーナーへのバイアスのかかった更新はサンプラーに伝播し、サイクルが繰り返されるにつれて誤差が蓄積される。
スコアセンタリングはドリフトを加法的に補正する
スコアセンタリングは、各サンプリングされたトークンのスコアからサンプラー下での期待スコアを減算する。センタリングされたスコアは各プレフィックスで期待値がゼロになり、ドリフトを除去する。
効率的な近似と重要度サンプリングの組み合わせ
補正は、サンプラーのtop-kトークン確率のみを用いて近似でき、kは32または128に等しく、残りの確率質量はトレーナーの分布で近似される。最高の性能は、スコアセンタリングを切り捨てまたはマスク付き重要度サンプリングと組み合わせることでしばしば達成され、これは非常に古いロールアウトなどの極端な不一致に役立つ。