
MetaがSAM 3とSAM 3Dを発表
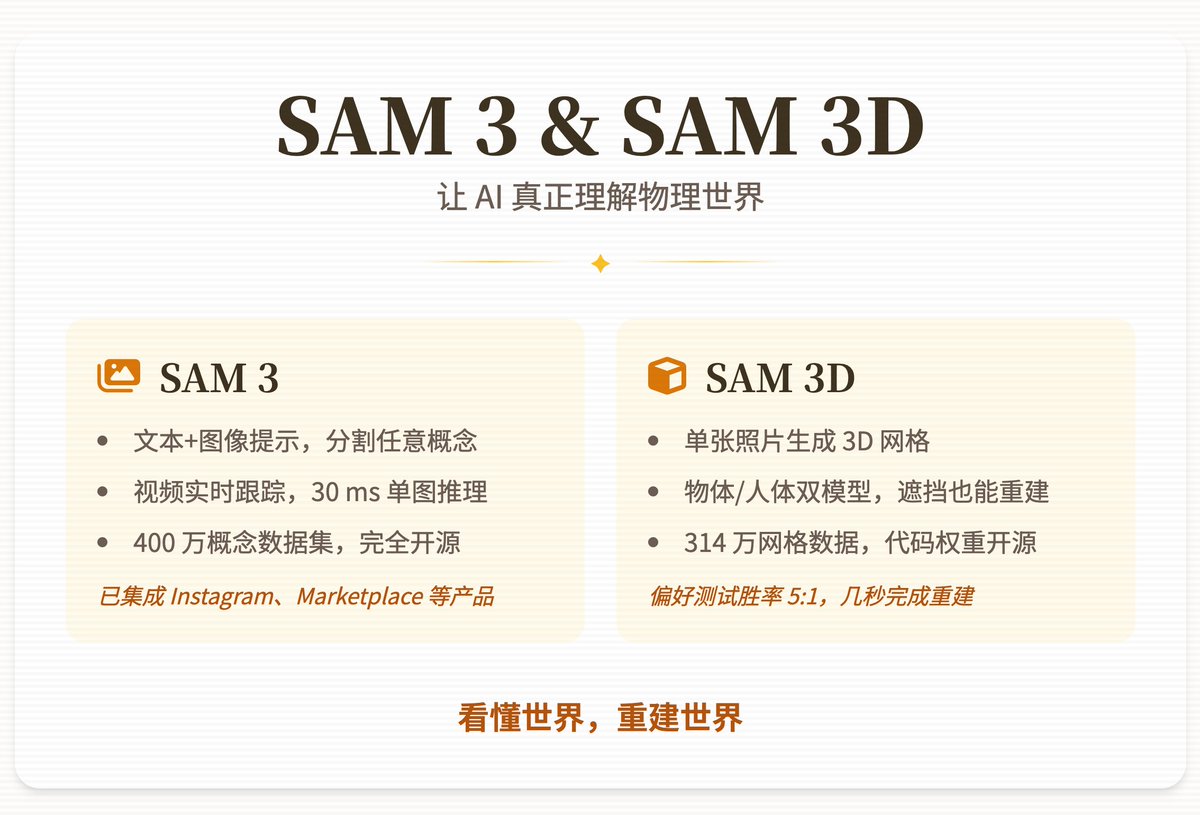
Metaは2025年11月20日に新しいモデル、SAM 3とSAM 3Dを発表しました。SAM 3はポイント、ボックス、マスクのプロンプトに加えて、新しいテキストと画像の例プロンプトをサポートしています。オープンボキャブラリーの概念レベルのセグメンテーションを実現し、複合概念を処理できます。SAM 3は動画内でリアルタイムの物体追跡を実現し、第一人称の眼鏡動画などの動的シーンをサポートします。SAM 3はLlamaなどと統合されたマルチモーダル大規模言語モデルの視覚ツールとして機能します。SAM 3はSA-CoベンチマークでGemini 2.5 Proなどの先行モデルに対して約2倍の改善を示しています。単一画像(100以上の物体)の推論は約30ms(H200 GPU)で、動画はほぼリアルタイムです。400万以上のユニークな概念データを使用してAI +人間のハイブリッドラベリング(Llama 3.2vによる検証)でトレーニングされています。すべてのモデルの重み、評価データセット(SA-FARIを含む)、微調整コードはオープンソースです。SAM 3DにはSAM 3D ObjectsとSAM 3D Bodyの2つのサブモデルが含まれており、物体と人体の再構築を目的としています。SAM 3Dは、単一の自然写真からテクスチャ付きのポーズ可能な3Dメッシュを生成できます。「model-in-the-loop」データエンジンを使用しており、AIが粗い3Dを生成し、人間が評価/修正し、約314万のメッシュ注釈を生成します。SAM 3Dは合成事前トレーニングと実データの多段階整合を採用し、セグメンテーションマスクや2Dキーポイントなどのインタラクティブなプロンプトをサポートします。人間の好みテストでは、SAM 3Dは既存の最良モデルに対して少なくとも5:1で勝っています。生成速度は数秒です。2つのサブモデル、重み、新しいデータセットSA-3DAO、人体パラメトリックモデルMHRは緩やかなライセンスでオープンソースです。製品統合の例として、Instagram Edits、Meta AI Vibes、Facebook Marketplaceの「View in Room」などが含まれています。
Key insights
SAM 3:オープンボキャブラリーとマルチモーダルプロンプトの統一セグメンテーションエンジン
SAM 3は、ポイント、ボックス、マスクのプロンプトを継承し、テキストと画像の例プロンプトを新たに導入した統一された画像および動画の「任意セグメンテーション」モデルとして位置付けられています。オープンボキャブラリーの概念レベルのセグメンテーションを実現し、細粒度および複合概念を処理でき、動画内でリアルタイムの物体追跡と第一人称動画のサポートを可能にします。400万以上のユニークな概念に基づくAI +人間のハイブリッドラベリングプロセスでトレーニングされており、SA-Coベンチマークで競合他社に対して約2倍の性能向上を示し、単一画像の推論は約30ms(H200)です。
SAM 3D:単一画像からインタラクティブな3Dメッシュを生成
SAM 3DにはObjectsとBodyの2つのサブモデルが含まれており、単一の自然画像から物体と人体の3D形状、テクスチャ、およびレイアウトを再構築できます。SAM 3D Bodyは、複数の視点や深度センサーがない場合でも完全な人体の姿勢と形状を復元でき、遮蔽や異常なポーズをサポートします。再構築結果は回転、スケーリング、ポージングが可能で、生成速度は数秒、解像度は中程度で、遮蔽や間接的な視点に対して堅牢性があります。
Model-in-the-loopデータエンジンによる大規模3D注釈
SAM 3Dのトレーニングは「model-in-the-loop」データエンジンに依存しています。AIは最初に粗い3Dを生成し、その後人間が難しいケースを評価および修正し、数百万の高品質な注釈セットを形成します(報告書では314万のメッシュが言及されています)。合成データの事前トレーニングと実データの整合を組み合わせた多段階トレーニングプロセスにより、シミュレーションから現実へのギャップを解決し、単一画像の3D再構築能力を支えています。
オープンソース戦略と産業統合
MetaはSAM 3とSAM 3Dのモデルの重み、評価データセット(SA-FARI、SA-3DAOを含む)、微調整コード、および人体パラメトリックモデルMHRを緩やかなライセンスでオープンソースにしています。製品面では、Instagram Edits、Meta AI Vibes、Facebook Marketplaceの「View in Room」などにSAM 3の機能が統合されており、動画効果、商品の3Dビジュアライゼーション、野生動物モニタリングなどのアプリケーションシナリオをカバーしています。
パフォーマンスと使いやすさの指標
Metaの報告書には重要な指標が示されています。SAM 3は標準ベンチマークでGemini 2.5 Pro、GLEE、OWLv2などに対して約2倍の性能を示し、単一画像(100+物体)の推論は約30ms(H200)で、動画はほぼリアルタイムです。SAM 3Dは人間の好みテストで既存の最良モデルに対して少なくとも5:1で勝ち、生成速度は数秒で、インタラクティブなプロンプトによる再構築をサポートします。
プロンプトインタラクションとマルチモーダルツールチェーンの価値
SAM 3はテキストと画像の例プロンプトをサポートしており、ユーザーの自然言語や例画像に基づいて「類似のもの」をセグメント化でき、マルチモーダル大規模モデル(例:Llama)の視覚ツールとして接続され、複雑な視覚推論や下流タスクの制御性を向上させます。SAM 3Dもセグメンテーションマスクや2Dキーポイントなどのインタラクティブなプロンプトを使用して3D再構築プロセスをガイドします。