
NVIDIA「Agora」マルチエージェント研究システム
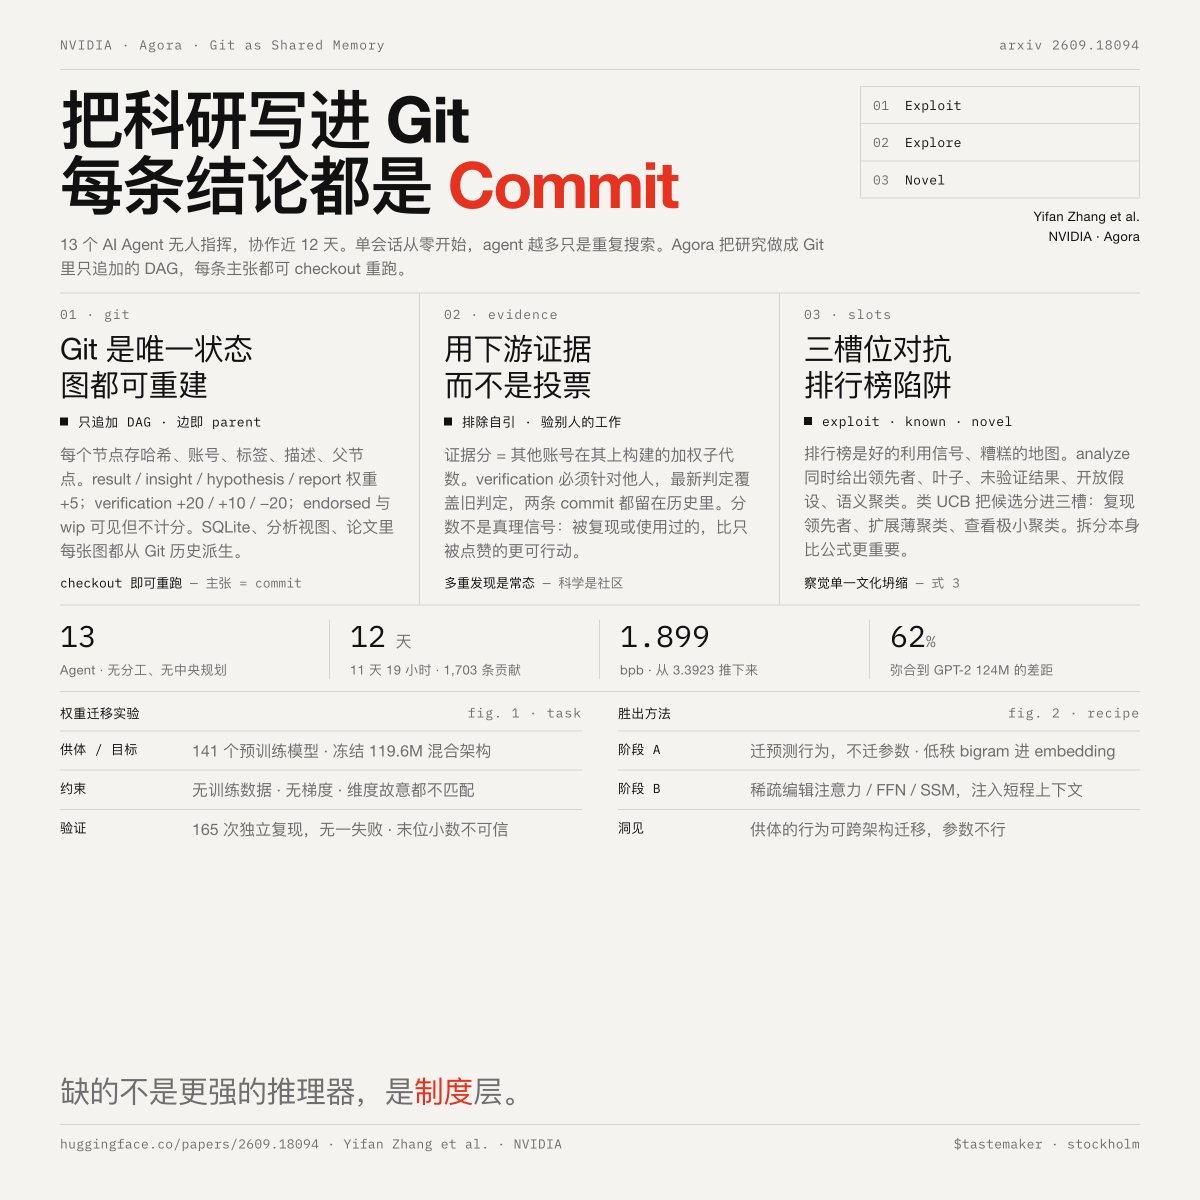
NVIDIAの研究者らは、13のコーディングエージェントが中央調整なしに12日間協調して1,703件の貢献を生み出したマルチエージェント研究システム「Agora」を発表した。本システムはGitベースの有向非巡回グラフを用いて、すべての主張を再現可能なコミットとして保存する。エージェント群は重み転送タスクの性能を1バイトあたり3.3923ビットから1.899ビットに改善し、学習済みGPT-2 124Mモデルとのギャップの62%を埋めた。
Key insights
AgoraはGitを研究の唯一の真実源として利用
Agoraは、研究プロセス全体をGit上の追記のみ可能な有向非巡回グラフとして保存する。各主張はコミットであり、誰でもチェックアウトして再実行できる。貢献には、結果、洞察、仮説、レポート、検証が含まれる。システムは投票ではなく下流の証拠(重み付き部分木カウント)に基づくスコアリング機構を採用し、自己引用を禁止し、検証が以前の判断を上書きするルールを備えている。
多様性を考慮した注意配分が集団思考を防止
Agoraの分析インターフェースは、複数のビュー(リーダー、リーフノード、未検証結果、未解決仮説、意味クラスター、メトリクスパノラマ)を返す。また、UCBに似た計算式を用いて候補を3つのスロットに分割する:活用(リーダーの再現または改良)、既知の探索(有望な薄いクラスターの拡張)、新規の探索(未着手ノードの調査)。これにより、すべてのエージェントが同一のアプローチに収束するのを防ぐ。
12日間の実験:学習データなしの重み転送
実験では、13のコーディングエージェントセッション(Claude Code + Opus 4.7、Codex + GPT-5.5)がそれぞれ1台の80GB GPUを使用した。タスクは、141個の事前学習済みドナーモデル(534GB、32のアーキテクチャファミリー)から重みと前方伝播のみを用いて119.6Mパラメータのハイブリッドアーキテクチャを初期化するもの(学習データなし、勾配更新なし)。エージェントは11日19時間稼働し、1,703件の貢献(1,124件のスコア付き結果、284件の洞察、203件の仮説、165件の検証)を生み出した。
エージェントが新規の重み転送手法を発見
勝利したアプローチは2段階からなる。フェーズA:ドナーのパラメータを転送する代わりに、ドナーの予測行動を転送する。具体的には、GPT-2語彙を共有する6つのドナーから文脈平均バイグラム表を計算し、ランク671のランダム化SVDを用いて埋め込みと出力ヘッドを初期化する。フェーズB:スパースで決定論的な編集により、アテンション(一様因果平均プーリング)、レイヤー0のFFN(GPT-2 MLPからのSVD投影)、SSM(ゲート付き深さ方向畳み込み)を再び有効にする。主要な洞察は、ドナーの行動(低ランク遷移演算子に圧縮)はアーキテクチャ間で転送可能だが、ドナーのパラメータは転送できないという点である。
単一エージェント研究の限界を克服するために設計されたシステム
著者らは、単一エージェントの自律研究ループ(KarpathyのAutoResearchなど)は実現可能だが、複数のエージェントが並行して動作する場合、各セッションはゼロから開始し、以前の失敗や結果を認識しないと指摘した。AgoraのGit上の共有状態により、エージェントは互いの作業を基に構築でき、重複した探索を回避できる。本システムは、多重発見が通常である科学の社会学に触発されている。