
NVIDIA:アテンション機構のアーキテクチャが長文脈モデルの推論速度の上限を決定
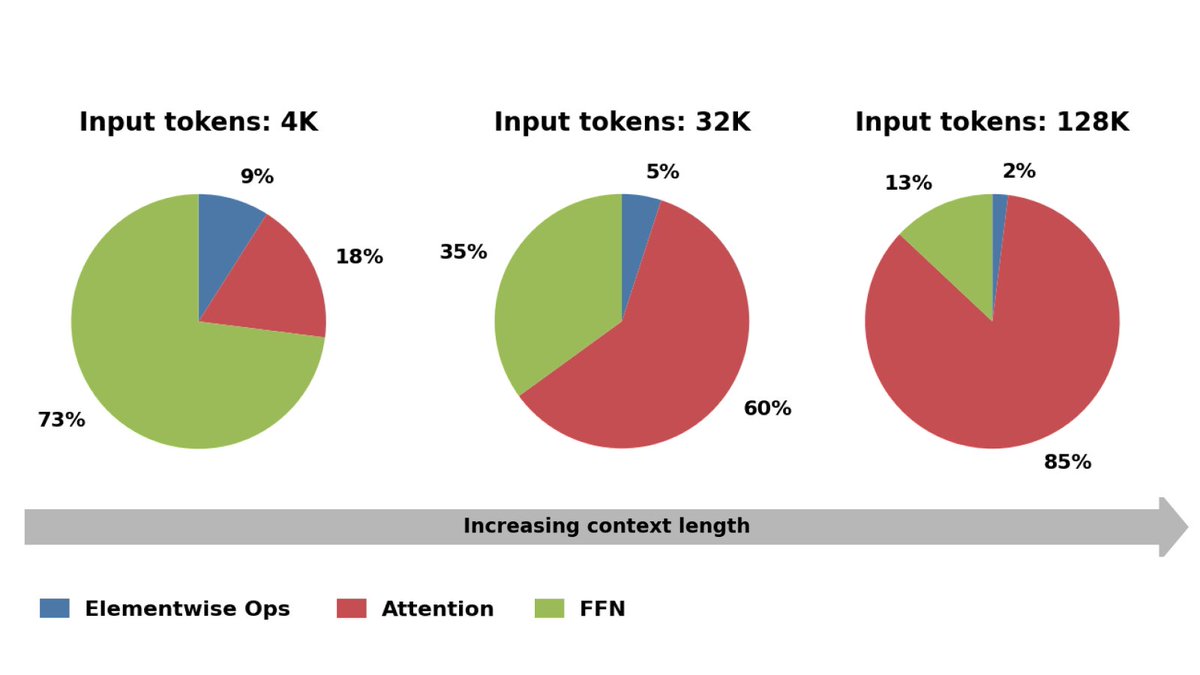
長文脈モデルの推論速度は、訓練開始前にほぼ決定される。これまでアテンションは推論コストの一部に過ぎなかったが、文脈ウィンドウが拡大するにつれてその割合は急増する。アテンションが支配的になると、高速なカーネルだけでは不十分となり、アテンション機構のアーキテクチャが性能の上限を決める。NVIDIAのAIモデル共同設計シリーズでは、この上限を決定する4つのアーキテクチャ選択肢(グループサイズ、ヘッド次元、KVキャッシュサイズ、並列化戦略)を検討する。本稿では、適切な選択がシステム全体のスループットとユーザーごとの応答性をいかに向上させるかを説明する。