
NVIDIA、エージェント研究向けのオープンソースPyTorchネイティブRLフレームワーク「Molt」を公開
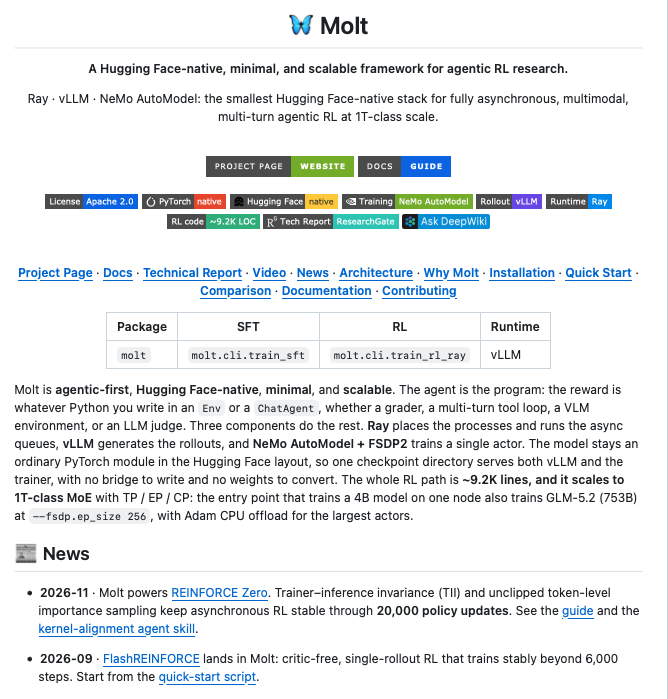
NVIDIAは、Ray、vLLM、およびFSDP2を備えたNVIDIA AutoModel上に構築された、エージェント研究向けのオープンソースPyTorchネイティブ強化学習フレームワーク「Molt」を公開した。このフレームワークは、EnvまたはChatAgentインターフェース内のPython関数を通じて報酬を定義し、同じトレーニングスクリプトで8Bモデルから1TクラスのMoEまでスケールする。
イベントのバージョン 1.
Key insights
最小限の3コンポーネントスタック
Moltのスタック全体は、配置と非同期キューのためのRay、ロールアウトのためのvLLM、トレーニングのためのFSDP2を備えたNVIDIA AutoModelで構成されている。スタックは意図的に最小限であり、トレーニング可能なアクター1つとオプションのKL参照ワーカーを備える。
事前トレーニング済み報酬モデル不要のPython定義報酬
Moltの報酬は任意のPython関数であり、数学的グレーダー、LLM-as-judge、マルチターンツール評価器、VLM環境などを含む。ユーザーはEnvまたはChatAgentクラス内で「良い」とは何かを定義し、事前トレーニング済み報酬モデルは不要である。
2つのエージェントインターフェース
EnvインターフェースはGymnasiumスタイルで、フレームワークがLLMループを所有し、step()が報酬を返す。ChatAgentインターフェースはOpenAIまたはAnthropic SDKを介してループを提供するため、これらのAPIを話す外部ハーネスは変更なしで動作する。
8Bから1TクラスMoEへのスケーリング
8Bモデルをトレーニングする同じスクリプトが1TクラスMoEにスケールする。DeepSeek-V3クラスのアクターは、TP、EP、CP並列処理とAdam CPUオフロードを備えたep_size 256で実行され、スケール間で書き換えは不要である。
サポートされるアルゴリズム
MoltはREINFORCE、REINFORCEベースライン、RLOO、GRPO、DR-GRPO、GAE(PPO)、およびオンポリシー蒸留をサポートする。ロールアウト、トレーニング、重み同期は完全に非同期でオーバーラップする。