
OpenAIエージェント研究:コンテキスト、モニタリング、GPT-5.2-Codex
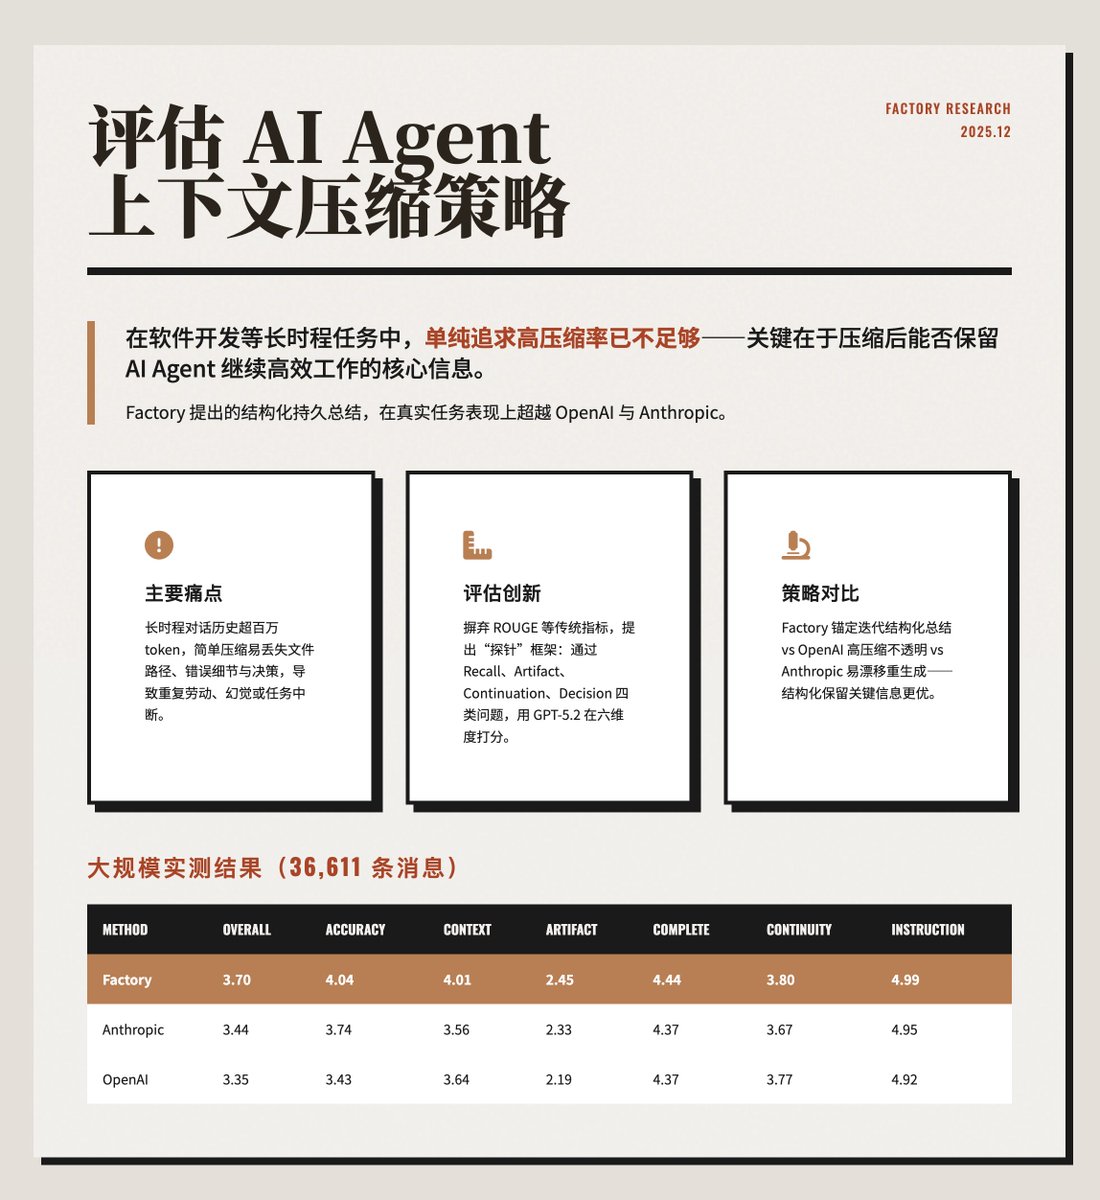
OpenAIがエージェントに焦点を当てた研究と新しいコーディングモデルを発表しました。長期間にわたるAIエージェントのためのコンテキスト圧縮戦略を比較した評価が行われました。継続的なタスクにおいては、高圧縮だけでは不十分であり、圧縮されたコンテキストは重要な実行可能な詳細(ファイルパス、エラー、決定)を保持する必要があります。FactoryAIのアンカリング反復構造要約は、タスク継続メトリクスにおいてOpenAIやAnthropicを上回りました。OpenAIの/responses/compactは99.3%の圧縮を達成しましたが、低エントロピーの技術的詳細を失いました。Anthropicは構造化された要約を生成しましたが、毎回再生成するためドリフトが発生しました。新しいプローブベースの評価は、GPT-5.2を採点者として使用し、リコール、アーティファクト、継続、決定をテストしました。BoxのCEOは「コンテキストエンジニアリング」が次のシステムの防壁であると主張し、情報検索、ヒューリスティックランキング、プロンプト、状態/空間最適化が必要であると述べました。OpenAIのChain-of-Thought(CoT)モニタリング可能性に関する研究では、内部の推論が長くなることでモニタリング可能性が向上することが示されました。「モニタリング可能性税」が存在し、小型モデル+深い思考が大型モデル+浅い思考よりも有利であることが示されています。現在の強化学習は、現在のスケールでCoTのモニタリング可能性を低下させておらず、フォローアップ質問が透明性を高める可能性があります。OpenAIは2025年12月18日にGPT-5.2-Codexを発表しました。これは、長期タスクのためのエージェント的コーディングモデルとして位置付けられ、ネイティブなコンテキスト圧縮、安定性、セキュリティ機能の向上、視覚/UI理解を備えています。ベンチマークでは、SWE-Bench Proが56.4%、Terminal-Bench 2.0が64.0%で、GPT-5.1を上回りました。
Key insights
構造化要約がエージェントの継続性において極端な圧縮を上回る
コンテキスト圧縮戦略を比較した評価では、構造化された持続的要約(FactoryAIのアンカリング反復構造要約)がファイルパス、エラー追跡、決定、次のステップなどの実行可能な技術的詳細を保持し、AIエージェントが長期間のタスクを効果的に継続できることが示されました。圧縮を最大化する方法(OpenAIの/responses/compactで99.3%の削減)は、しばしば低エントロピーだが重要なデータを失い、繰り返し作業や幻覚を引き起こしました。プローブベースの評価は、リコール、アーティファクト、継続、決定をGPT-5.2を審査員としてテストし、正確性、コンテキスト認識、アーティファクト追跡、整合性、継続性、指示遵守の観点からスコアを付けました。
エージェントシステムの戦略的防壁としてのコンテキストエンジニアリング
BoxのCEOは、高度なエージェントの失敗が推論能力から関連する背景情報の欠如に移行していると主張しました。投稿では、投資すべき4つの領域が挙げられています:大規模な低遅延の情報検索とリコール、取得したコンテキストのヒューリスティックランキング、タスクを定義するためのシステムプロンプトエンジニアリング、限られたウィンドウにより正確なコンテキストを適合させるための状態/空間最適化。投稿は、計算駆動の情報処理がAIの独自の利点であることを強調しています。
深い推論によってCoTのモニタリング可能性が向上するが税が発生する
OpenAIの研究は「CoTモニタリング可能性」を説明し、モデルに長い内部推論を許可することで、その推論が外部モニターにとってより観察可能になることを発見しました。この研究は「モニタリング可能性税」を特定し、深い推論を持つ小型モデルは、浅い応答を持つ大型モデルよりも監視が容易であることを示しています。現在の強化学習信号は、主要なスケールでモニタリング可能性を実質的に低下させておらず、ターゲットを絞ったフォローアップ質問が透明性を高める可能性があります。
長期タスク処理とセキュリティが向上したエージェント的コーディングモデルとしてGPT-5.2-Codexが発表
OpenAIは2025年12月18日にGPT-5.2-Codexを発表し、これを自律エンジニアのように機能するエージェント的コーディングモデルとして位置付けました:ターミナルで実行し、コードを書いてデバッグし、ネイティブなコンテキスト圧縮と反復的安定性を通じて長期タスクに集中します。このモデルはサイバーセキュリティ支援を改善し(以前のモデルによるReactの脆弱性の発見が注目されています)、設計スケッチをプロトタイプコードに変換するための視覚/UI理解を追加します。ベンチマーク結果では、SWE-Bench Proが56.4%、Terminal-Bench 2.0が64.0%で、GPT-5.1を上回っています。