
Qwen-Image-2.1 オープンソース画像モデルとローカルデプロイ
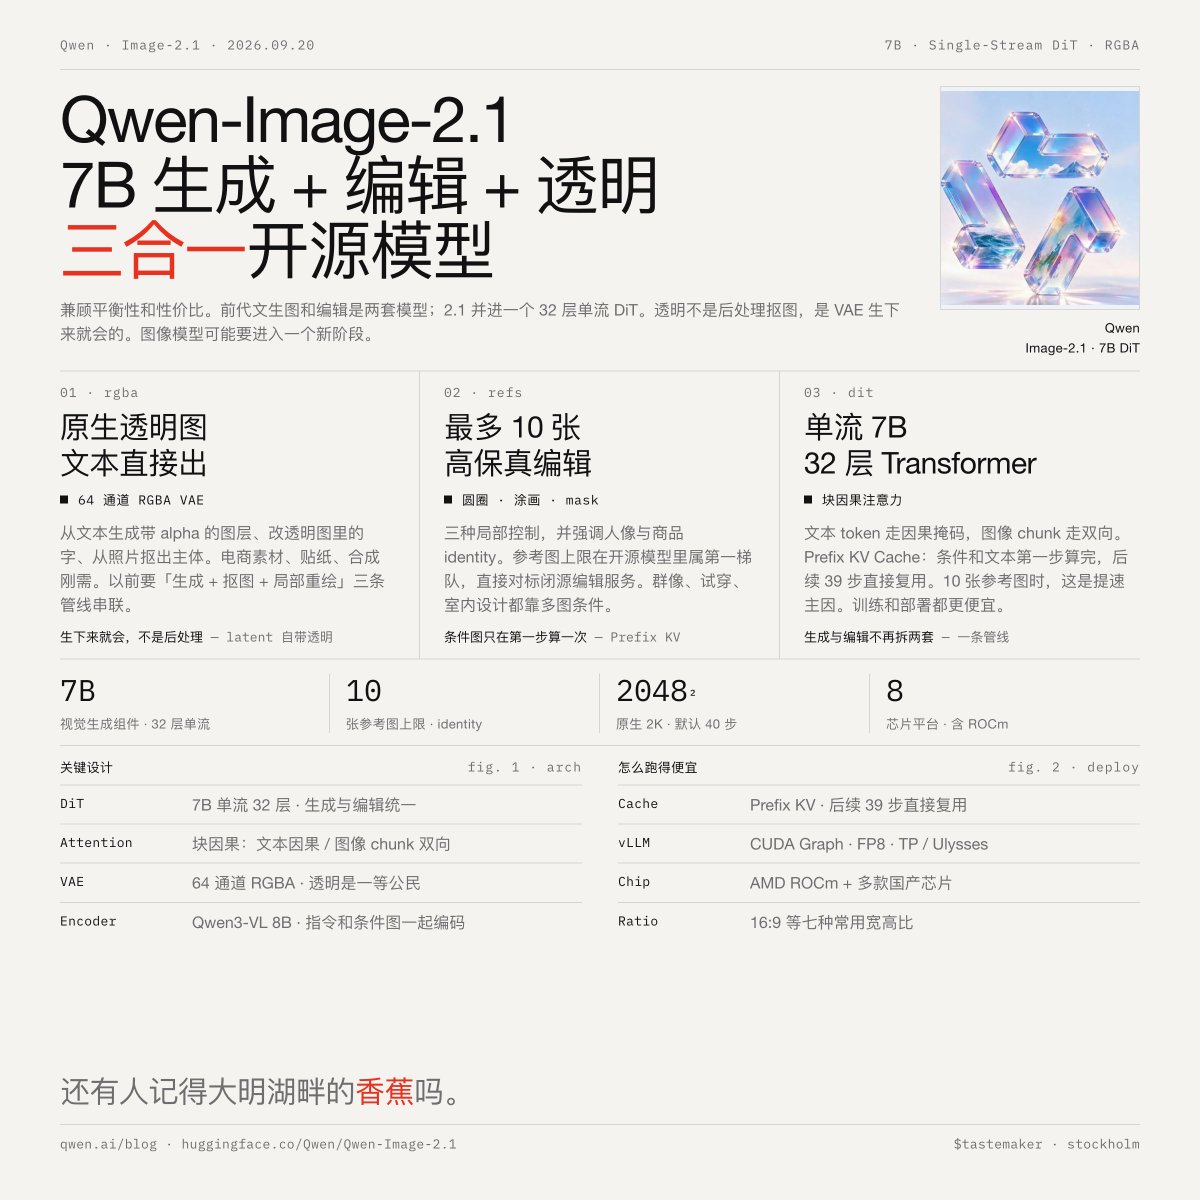
Alibabaは、テキストから画像生成、編集、透明画像出力を統合したオープンソースの7BパラメータDiTモデル「Qwen-Image-2.1」を公開しました。最大10枚の参照画像による編集、ネイティブRGBA出力、2K解像度に対応。vLLMによるデプロイに最適化され、8つのチッププラットフォームをサポート。Unsloth GGUF量子化により12GB VRAMまでダウンサイジング可能で、ローカルデプロイが実現できます。
Key insights
統一されたアーキテクチャと機能
Qwen-Image-2.1は、従来の生成と編集で別々だったモデルを置き換え、32層のシングルストリームDiTを採用。ブロック因果注意(テキストトークンには因果マスク、画像チャンクには双方向マスク)を特徴とする。このモデルは、潜在空間にアルファチャネルを持つ64チャンネルVAEによりRGBA画像をネイティブ生成し、別途マッティングパイプラインを不要にします。
複数参照画像による編集
本モデルは、忠実度の高い編集のため最大10枚の参照画像をサポートし、円注釈、落書きマーキング、独立マスクの3つのローカル制御方式を提供。人物や製品のアイデンティティ保存を重視。プレフィックスKVキャッシュにより、条件画像とテキストを最初のデノイジングステップで一度計算し、残りの39ステップで再利用することで、複数画像編集を大幅に高速化します。
テキストレンダリングと品質改善
Qwen-Image-2.1は、テキストレンダリング、ポートレート照明、リアルなテクスチャにおいて質的な改善を示しています。中国語テキストレンダリングはQwen-Imageシリーズから継承した特に強み。テキストエンコーダにQwen3-VL 8Bを採用し、テキスト指示と条件画像のエンコーディングを統一、複雑な指示追従を改善します。
デプロイとハードウェアサポート
本モデルは、CUDA Graph、FP8量子化、TP/Ulysses並列化を含むvLLMデプロイオプションをサポート。AMD ROCmや複数の国産チップを含む8つのチッププラットフォームと互換性があります。デフォルトの推論は40ステップ、ネイティブ2K解像度(2048²)、16:9を含む7つの一般的なアスペクト比をサポートします。
Unsloth量子化によるローカルデプロイ
UnslothAIは、Qwen-Image-2.1のGGUF量子化バージョンを公開し、コンシューマーGPUでのローカルデプロイを可能にしました。12~16GB VRAM(例:RTX 4070)では、Q4_K_M量子化で1024x1024動作。6GB VRAMでは、オフローディングによる動的FP8が高精度ながら低速。24GB VRAMでは、INT8が最高品質(LPIPS 0.064、FP8は0.112)を実現。CPUやApple Siliconも12~16GBメモリでサポートされます。
従来モデルとの比較
Qwen-Image-2.1は、従来別々だったQwen-Image(生成)とQwen-Image-Edit(編集)モデルを単一の7B DiTに統合。これによりトレーニングとデプロイのコストを削減します。ネイティブな透明画像機能は、後処理のマッティングが必要な競合とは根本的に異なります。最大10枚の参照画像を扱える能力はオープンソースモデルの中でもトップクラスであり、GPT-Imageのようなクローズドソース編集サービスと直接競合します。