
Raw-RAG、長期会話ベンチマークでエージェント型メモリを上回る
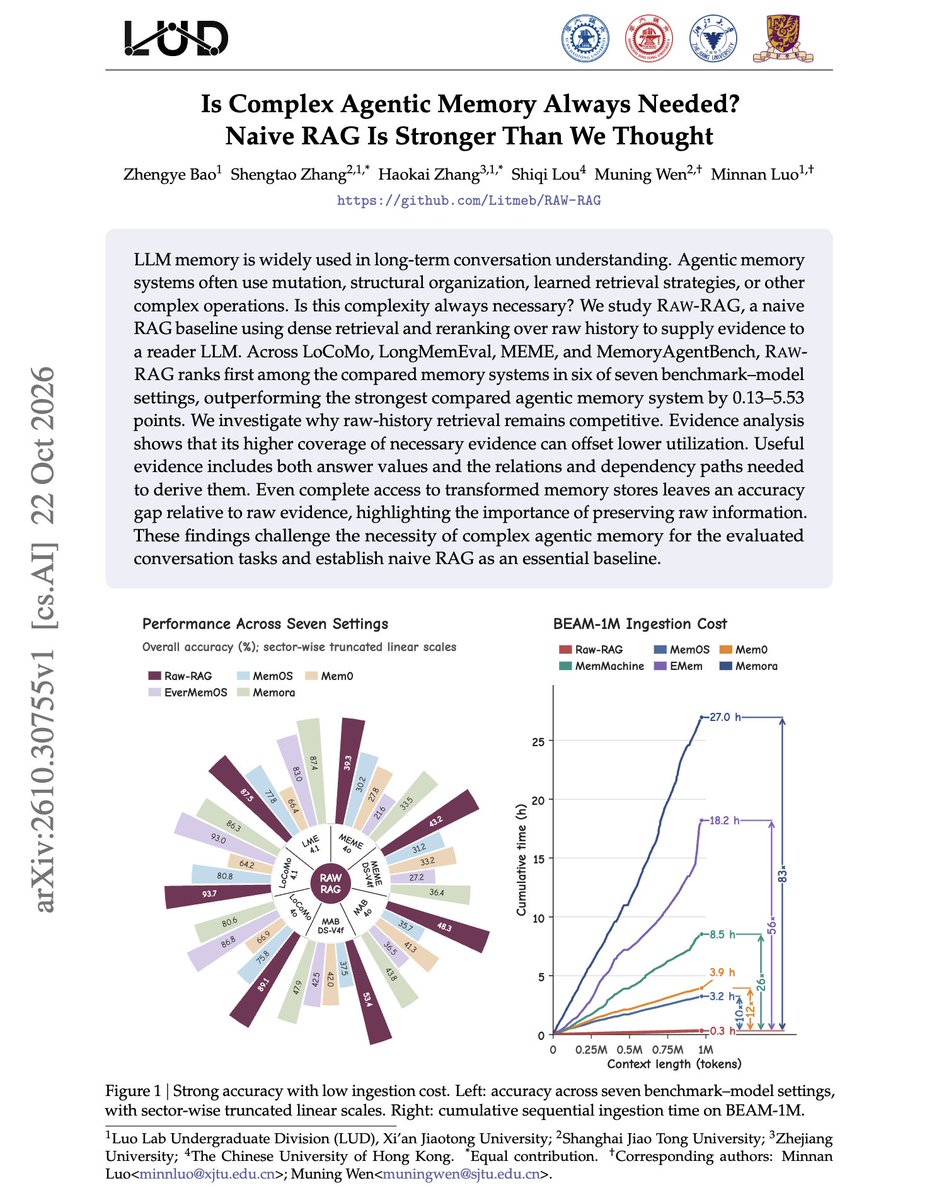
Zhengye Bao氏らによる研究は、生の会話履歴に対して密検索と再ランキングを用いる単純な検索ベースラインであるRaw-RAGが、LoCoMo、LongMemEval、MEME、MemoryAgentBenchの7つのベンチマーク・モデル設定のうち6つで1位となったことを明らかにした。Raw-RAGは最強のエージェント型メモリシステムを0.13~5.53ポイント上回り、BEAM-1Mの取り込み時間は0.3時間であったのに対し、比較対象のメモリシステムでは3.2~27.0時間であった。
イベントのバージョン 1.
Key insights
Raw-RAGがほとんどのベンチマーク設定で首位
Raw-RAGは、LoCoMo、LongMemEval、MEME、MemoryAgentBenchの7つのベンチマーク・モデル設定のうち6つで、比較対象のメモリシステムの中で1位となった。比較対象の最強のエージェント型メモリシステムを0.13~5.53ポイント上回った。
取り込みコストははるかに低い
BEAM-1Mの取り込みにおいて、Raw-RAGは0.3時間を要したのに対し、MemMachine、MemOS、EMem、Mem0、Memoraでは3.2~27.0時間であった。著者らはこれを約10倍から83倍安価であると述べている。
証拠の網羅性が結果を説明する
生の履歴は、回答の背後にある関係や依存経路を含め、質問が必要とする証拠をより多く網羅しており、それが利用率の低さを相殺している。メモリエントリへの変換はそれらの要素を失いがちである。
オラクルテストは生の証拠に軍配
変換されたメモリストアへの完全なアクセスがあっても、生の証拠と比較して精度の差が残った。著者らは、生の情報を保持することが、その上に構築される構造よりも重要であると述べている。
アブレーションはデフォルトを上回らない
再ランキングを削除すると性能が3.92ポイント低下し、1つのパッセージのみを返すと11.73ポイント低下した。原子的な事実抽出、要約の拡張、グラフ拡張を追加しても、デフォルトのRaw-RAGスコア48.32を超えることはなかった。