
Viggle、Physics-Native Tokensを採用した3Dネイティブ世界モデル「JST-2」を公開
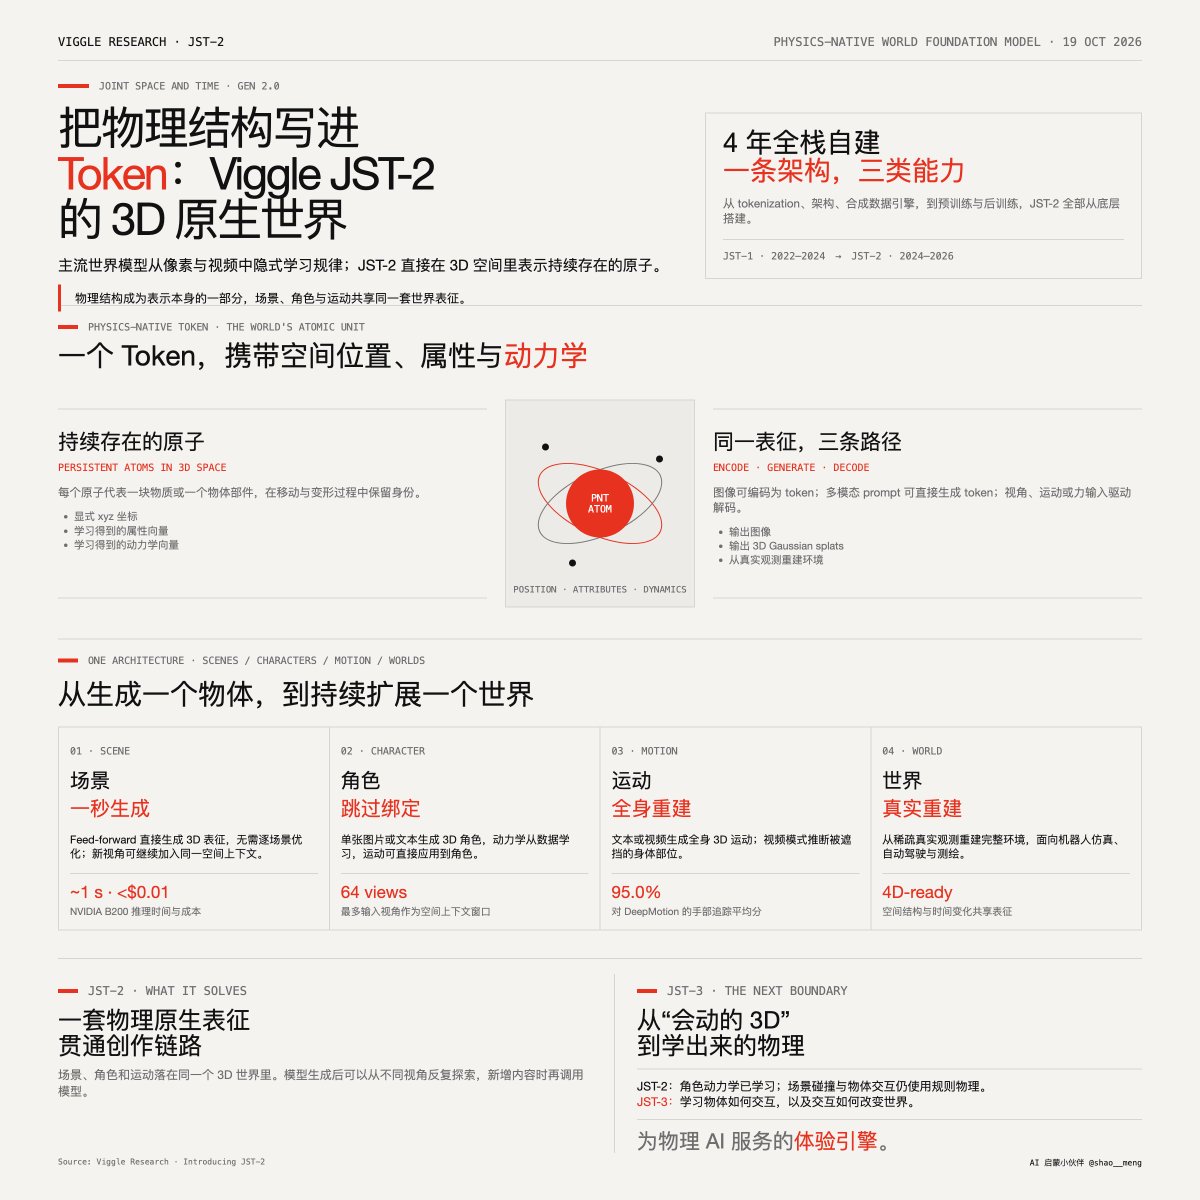
Viggleは、明示的なxyz座標、学習済み属性ベクトル、学習済みダイナミクスベクトルを保持するPhysics-Native Tokensを用いて、完全に3D空間内で構築された世界モデル「JST-2」を公開した。このモデルは、B200上で1シーンあたり0.01ドル未満で約1秒で完全な3Dシーンを生成し、リギングやスキニングなしで単一画像またはテキストから3Dキャラクターを生成し、テキストまたは動画から全身モーションを生成する。Viggleは、Meshy、Tripo、Cartwheel、DeepMotionに対する盲検人間選好テストでの勝利を報告し、JST-3では学習済みダイナミクスを物体相互作用に拡張すると概説した。
イベントのバージョン 1.
Key insights
表現に物理を埋め込む
JST-2は世界を永続的な3D原子としてモデル化し、各原子は明示的なxyz座標、学習済み属性ベクトル、学習済みダイナミクスベクトルを保持する。物理構造はピクセルの見た目から推測されるのではなく、表現の一部となっている。
3コンポーネント構成
JSTエンコーダは画像を物理ネイティブトークンに変換し、JSTジェネレータはマルチモーダルプロンプトから直接トークンを生成し、JSTデコーダは視点とモーションまたは力の入力を組み合わせて画像または3Dガウシアンスプラットを出力する。
4年間にわたる自社構築フルスタック
Viggleはトークン化、アーキテクチャ、データ合成エンジン、事前学習、事後学習を自社で構築し、JST-1は2022年から2024年、JST-2は2024年から2026年にわたる。3Dネイティブな訓練データは自然界にほとんど存在しないため、合成データが不可欠である。
統合された生成能力
JST-2はB200上で1回のフォワードパスあたり約1秒、0.01ドル未満で完全な3Dシーンを生成し、空間コンテキストウィンドウとして最大64の入力ビューをサポートし、リギングとスキニングなしで1枚の画像またはテキストから3Dキャラクターを生成し、疎な実観測から完全な3D環境を再構築する。
盲検選好結果とJST-3ロードマップ
盲検人間選好テストにおいて、JST-2はキャラクター生成でMeshy 7.1に対して58.4%、Tripo H3.1に対して73.2%で勝利し、動画駆動モーションではCartwheelに対して58.1%、DeepMotionに対して89.1%で勝利し、ハンドトラッキングは95%であった。JST-3は学習済みダイナミクスを物体相互作用に拡張し、ルールベースのシミュレーションを置き換えることを目指す。