
ウェブスクレイピングと自動化ソリューション
記事コンテンツを抽出し、動的ウェブスクレイピングを自動化するためのツールとアプローチ。
Key insights
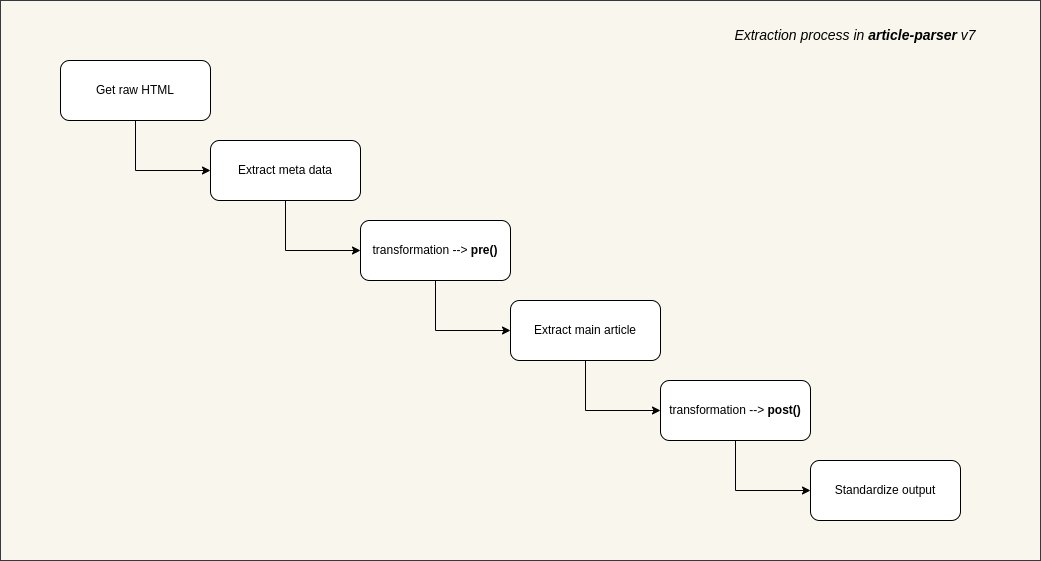
クリーンな記事抽出のためのarticle-extractor
ある投稿では、広告、サイドバー、ナビゲーションを排除し、混雑したウェブページからコア記事データを抽出するために設計されたオープンソースのarticle-extractorライブラリが紹介されています。このライブラリは、タイトル、本文、カバー画像、著者、読了時間などの構造化されたフィールドを返し、ドメインごとのカスタム変換をサポートし、Node.js、Bun、およびブラウザと互換性があり、アンチスクレイピング戦略のためのプロキシとヘッダーの設定が可能です。
Doubaoがデバイス制御を通じて動的モバイルウェブスクレイピングを自動化
再投稿されたメモでは、DoubaoがAndroidデバイスを制御することでXiaohongshuとDouyinの動的読み込みの問題を解決したと報告されています。具体的には、スワイプをシミュレートし、スクリーンキャプチャに対してOCRを実行してカバーテキストを抽出し、インタラクションフローを自動化しています。この投稿は、Doubaoのアプローチを、これらの動的に読み込まれるページに対して失敗した以前のツール(comet、dia、manus)と対比させています。
集約ビジネスモデルがアンチボットの障害を克服
ある投稿では、シンプルな集約と配信が依然として有効な戦略であることが観察されています。具体的には、オペレーターがキャプチャチャレンジをバックエンドにルーティングし、タスクを人間の労働者に外注する例が示されており、スクレイピングと自動化の課題に対する実用的な解決策を示しています。