
エージェントの取得とメモリ:長タスクのための低遅延検索とコンテキスト圧縮
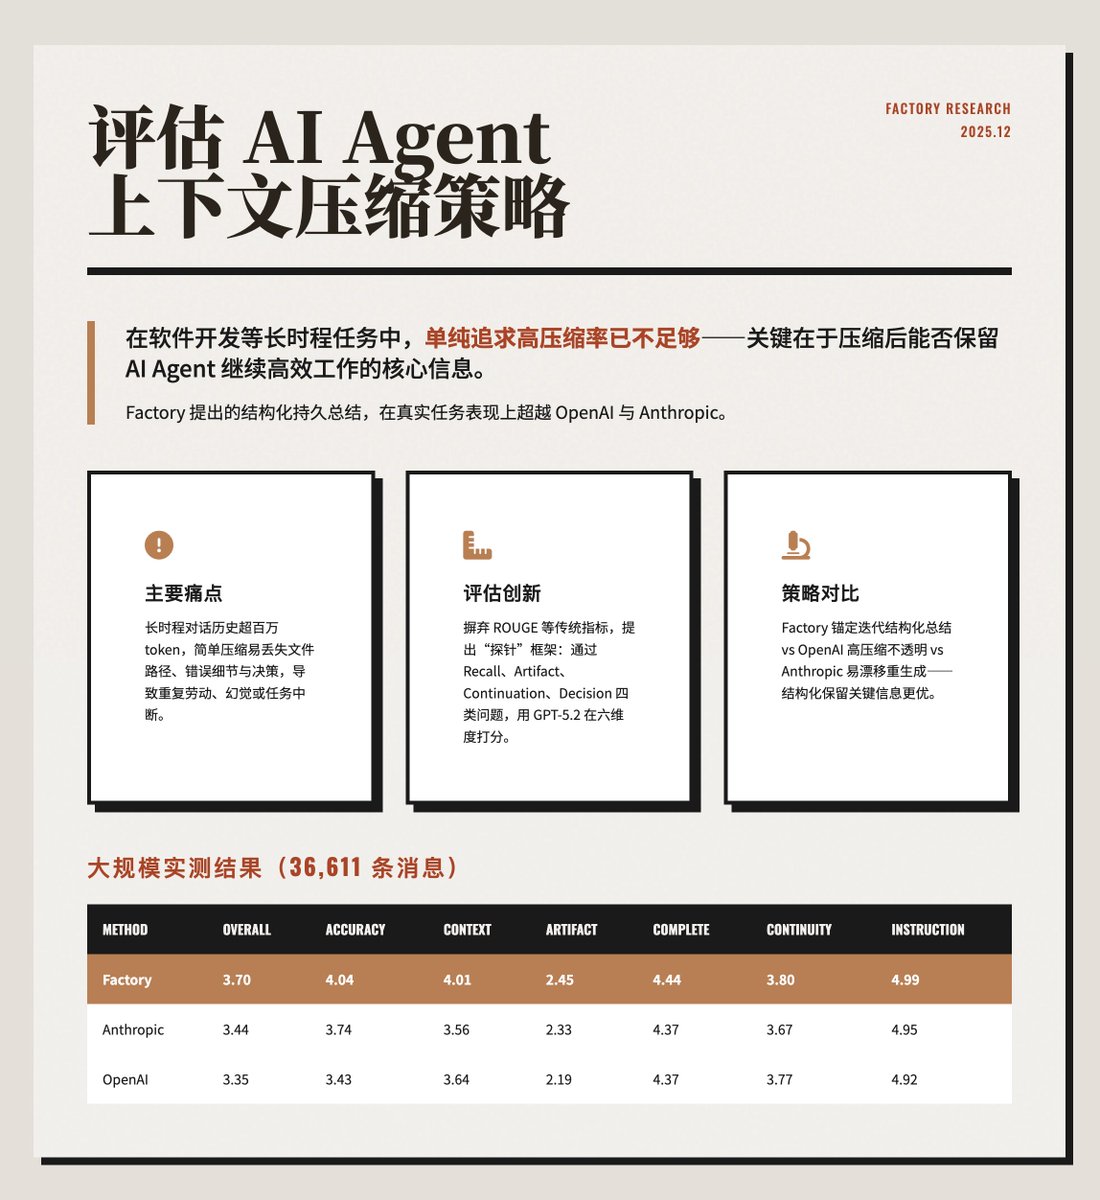
新たな評価により、構造化されたアンカー付き要約とミリ秒単位の取得が長時間実行されるエージェントタスクにとって重要であることが示されました。
Key insights
圧縮の質はアクション可能なアーティファクトを保持すべきであり、比率を最大化すべきではない
エージェントのコンテキスト圧縮の評価では、極端な圧縮(高比率)がファイルパス、エラートレース、意思決定アーティファクトなどの低エントロピーでありながら実用的な詳細をしばしば捨ててしまうことがわかりました。FactoryAIの「アンカー付き反復要約」は、構造化された持続的な要約(意図、ファイルの変更、決定)を維持し、連続性を保つことで、一般的な圧縮アプローチを上回りました。
プローブベースの評価はエージェントの圧縮ユーティリティをより良く測定する
研究者たちは、圧縮されたコンテキストのリコール、アーティファクト保持、継続、意思決定の追跡可能性をテストするためにプローブベースの評価を提案しました。このフレームワークは、圧縮後にターゲットクエリを使用して、タスクの継続に必要な主要要素がアクセス可能であるかどうかを検証します。ROUGEや埋め込みの類似性に依存するのではなく。
Opennoteのインデックスはミリ秒単位の取得とハイブリッドフィルタリングを強調
Opennoteは、Postgres(pgvector + pg_trgm + tsvector)とCloudflareエッジランタイムに基づいた取得システムであるインデックスを説明しました。これにより、マルチテナントの個人知識検索に対してP99 < 300msを実現しています。インデックスは、メタデータフィルタリング、ハイブリッドセマンティック+キーワード検索、細粒度キャッシング、チャンクレベルの無効化、最小限の再埋め込みを組み合わせて、エージェントの要件を満たします。
生産取得にはグローバルな分散、動的更新、正確な再ランキングが必要
Opennoteのパイプラインは、グローバルなWorkersベースの取り込み、再処理を避けるためのチャンクレベルのハッシュ化、キーワードとベクトルスコアの動的アルファブレンドをサポートしています。このアーキテクチャは、マルチテナントフィルタリングと進化する文書で作業するエージェントの正確性を維持するための即時キャッシュ無効化をサポートします。
エージェントメモリ設計は生の圧縮よりもタスクごとのトークンコストを最適化すべき
著者たちは、エージェントのワークフロー全体でエンドツーエンドのトークン消費を低く最適化することを推奨しました。構造化されたアンカー付き要約とアーティファクトインデックスは、再取得と生成コストを削減します。
実用的なインデックス選択は動的フィルタのためにリレーショナルエンジンを好む
Opennoteは、ベクトルのみのストアよりもPostgresベースの組み合わせ取得を選択しました。リレーショナルメタデータフィルタリングは、埋め込みの類似性の前に候補セットを効果的に減少させ、エージェントのルックアップのレイテンシとマルチテナントの分離を改善します。