
コンテキストエンジニアリングとAIエージェント
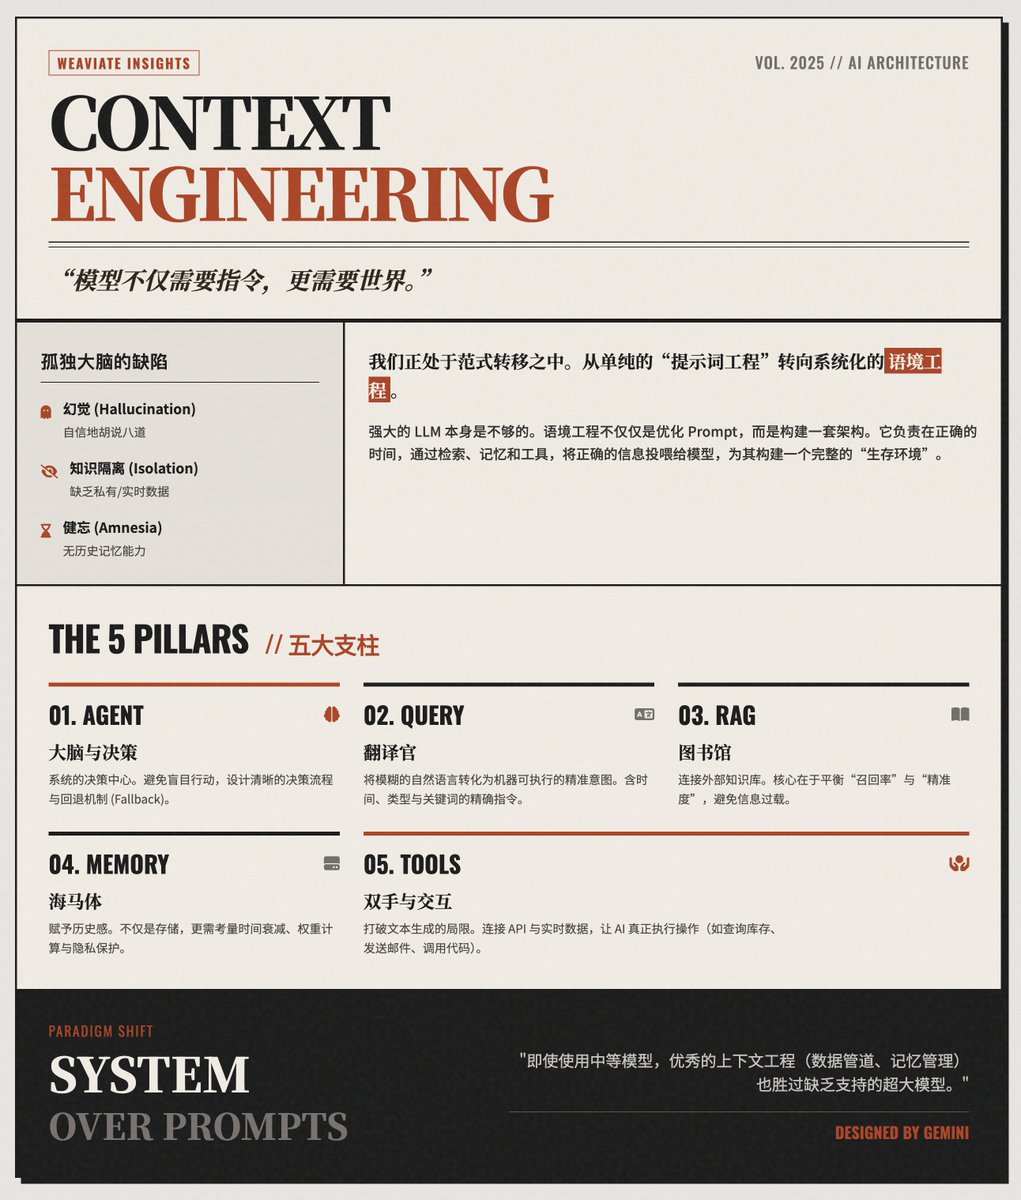
コンテキストエンジニアリングはエージェント設計を再構築します。
Key insights
LLMは自給自足ではない; コンテキストが必要
大規模言語モデルは、幻覚、知識の孤立(プライベートまたは最新のデータの欠如)、持続的なメモリの不在という三つの核心的欠陥を示しています(投稿17374、17331)。コンテキストエンジニアリングは、単にプロンプトを洗練させるのではなく、モデルに推論中にタイムリーで関連性のある情報を供給するメモリストア、検索レイヤー、ツールインターフェースを含む実行環境を構築するアーキテクチャ的応答として提示されています。主張は、高度なLLMであっても、世界に向けたデータと持続メカニズムに接続されない限り、孤立した「脳」として振る舞うというものです(17374、17331)。
生産AIを定義する五つの柱
生産AIのための具体的な五つの柱の青写真が提案されています: エージェント(意思決定センター)、クエリ拡張(意図翻訳者)、検索(知識ライブラリ)、メモリ(時間的コンテキストとプライバシー)、およびツール(APIとアクション)(投稿17374)。各柱には運用上の推奨事項があります: エージェントは明示的な意思決定フローとフォールバックを必要とし、クエリ拡張はあいまいなユーザーのクエリを正確な検索指示に変換し、検索システムはリコールと精度を調整し、メモリは重み付けと有効期限ポリシーを必要とし、ツールは現実世界のアクションを可能にする呼び出し可能なインターフェースとして公開される必要があります(17374)。
プロンプトエンジニアリングからシステム設計へのパラダイムシフト
資料は、プロンプトの文言に対する以前の強調がシステムレベルのコンテキストエンジニアリングに置き換わる方法論的シフトを繰り返しフレームしています(投稿17338、17374)。ガイダンスには「コーディングの前に計画する」(仕様駆動開発)、静的な貼り付けではなく、モデルコンテキストへの関連コード/ドキュメントの動的アセンブリ、より安全な出力のための役割ベースまたは制約ベースのプロンプトが含まれます。主張は、適切に設計されたコンテキストパイプラインが中規模モデルをコンテキスト設計のない大規模モデルよりも優れたものにできるというものです(17338、17374)。
コンテキストノイズを防ぐための技術的パターン
コンテキストノイズに対抗するためのエンジニアリングパターンには、ツール検索(すべてのツールをシステムプロンプトに埋め込むのではなく、ツール定義の動的読み込み)、プログラム的ツール呼び出し(コードをプライベートに実行し、要約された結果のみを公開)、およびモデルから大きな生データを分離してトークン汚染を避けることが含まれます(投稿17331)。これらの実践は、クリーンなコンテキストのために計算を取引し、モデルの注意を重要な情報に保ちます(17331)。
長時間タスクのためのエージェントアーキテクチャはアンカーを使用
長時間タスクには、二つのエージェントハーネスが推奨されます: イニシャライザーエージェントはグローバルな計画アーティファクト(例: feature_list.json、progress.txt)を作成し、後続のコーディングエージェントは長いチャットログではなく、これらのアンカーのみを読み取ります(17331)。外部ストレージ(ファイル、Gitコミット)は持続的なメモリ媒体として推奨され、エージェントに変更をコミットさせる(git commit)ことで、信頼できる、クエリ可能なプロジェクトメモリを提供します(17331)。
開発者ワークフロー: 仕様駆動、テストファースト、多エージェントオーケストレーション
AI支援開発のための推奨されるソフトウェアエンジニアリングプラクティスには、コーディングの前にミニPRD/仕様を作成すること、AIに計画を提案させること、AIにコードの前にテストを書くこと(赤-緑-リファクタ)、およびサンドボックスとロールバックポイントを持つ多エージェントパイプラインを実行することが含まれます(投稿17338)。コマンドライン常駐エージェントとオーケストレーションされたエージェントの役割(プランナー、コーダー、テスター、ドキュメンター)は、未来の開発環境として説明されています(17338)。
ツール: 決定論的出力、バックプレッシャー、ノイズフィルタリング
運用ツールの提案には、簡潔な決定論的出力(例: 成功時の単一のチェックマーク)をデフォルトとするラッパー、失敗時にのみ完全なログを公開すること、一度に一つのエラーを処理するためのクイックフェイル/テストバイルオプションの使用、失敗したアサーション行のみをフィルタリングすることが含まれます(投稿17373)。これらの対策はトークンの無駄を減らし、コンテキストウィンドウのオーバーフローを防ぎ、モデルを最適なトークン「インテリジェンスゾーン」に保ちます(17373)。