
コンテキスト圧縮、RAG、および長期エージェント評価
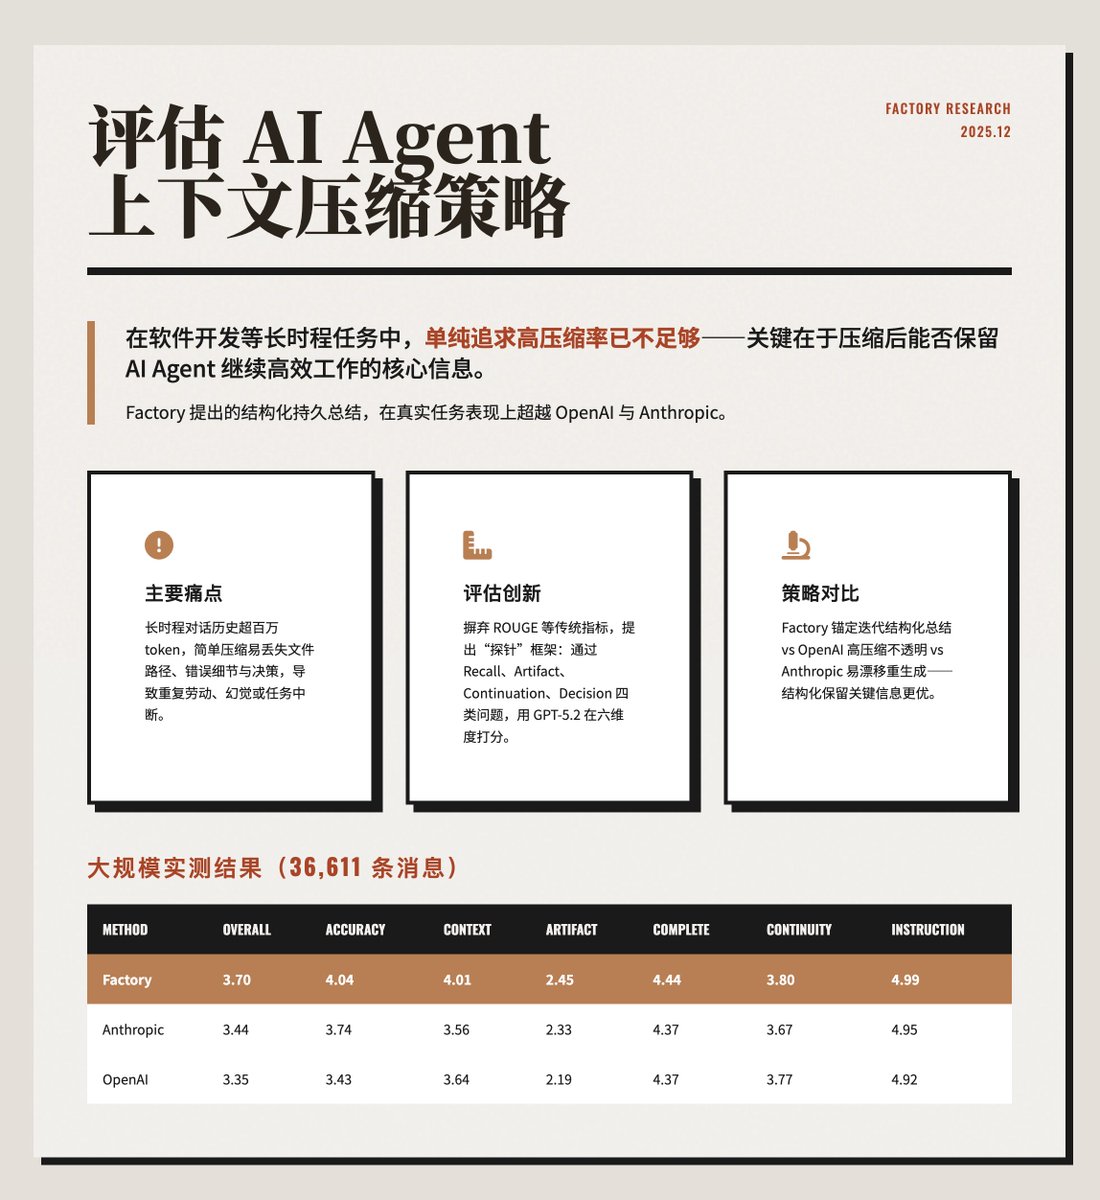
研究者と実務者は、長寿命エージェントのためのコンテキスト圧縮とRAGの改善を強調しています。- 単一セッションの圧縮では、100万トークン以上の履歴においてタスクに重要な詳細を保持できません。- FactoryAIのアンカー付き反復要約は、プローブベースの保持テストでOpenAIやAnthropicを上回りました。- プローブ評価は、リコール、アーティファクト、継続、意思決定の6つのスコアリング次元をGPT-5.2の審査員を通じて使用します。- 効率性は、最大圧縮比ではなく、タスクごとのトークン消費を最適化するべきです。- BoxのCEOであるLevieは、コンテキストエンジニアリングがエージェントにとって主要なシステムレベルの障壁になると主張しています。- 重要なインフラストラクチャ:検索、ヒューリスティックランキング、システムプロンプト、状態/空間の最適化。- Agentic RAG for Dummiesプロジェクトは、RAGのための対話メモリ、階層インデックス、および生産機能を追加しています。
Key insights
コンテキスト圧縮は実行可能な詳細を保持する必要がある
評価は、従来の高圧縮アプローチが低エントロピーでありながらタスクに重要な詳細(例:ファイルパス、エラーログ)を失うことを示しています。プローブベースのフレームワークは、リコール、アーティファクト追跡、継続、意思決定支援を測定し、GPT-5.2を評価者として使用し、0から5の6つの次元をスコアリングします。FactoryAIのアンカー付き反復要約は、OpenAIの不透明なコンパクトな応答やAnthropicの完全再生成要約よりも、意図、ファイル編集、意思決定、次のステップの計画をより良く保持します。この報告は、圧縮率を最大化するのではなく、進行中のタスクごとのトークン使用の最適化を強調しています。
コンテキストエンジニアリングはコアシステムアーキテクチャの問題になる
BoxのCEOであるLevieは、エージェントの失敗が論理的欠陥から情報の非対称性にシフトすると主張しています。彼は、大規模で低遅延の検索を必要とする情報供給チェーン、重要なコンテキストを優先するためのヒューリスティックソート、正確なシステムプロンプト、複雑な推論を限られたウィンドウに適合させるための状態/空間の最適化を概説しています。彼は、データをスキャンして再編成するためのAIの計算上の利点を強調し、コンテキストエンジニアリングを生産エージェントにとっての競争障壁として位置付けています。
生産RAGには対話メモリと階層インデックスが必要
Agentic RAG for Dummiesプロジェクトは、対話メモリ、階層インデックススライス、および小から大への検索戦略を追加することで、生産グレードのRAGを実証しています:小さなシャードで検索し、大きなコンテキストスライスでコールバックします。このシステムは、マルチエージェントのオーケストレーションをサポートし、幻覚を避けるための明確な質問、Gradio UI、文書管理、対話の持続性、人間の介入フック、PDFからMarkdownへのパイプライン、Docker展開、ローカル展開のためのノートブックチュートリアルを提供します。
トークン効率とプローブベースの評価に関する政策レベルの影響
実用的な推奨事項は、圧縮メトリクスがタスクの連続性の効果を反映する必要があるということです:タスクごとのトークン消費とアーティファクトの追跡可能性は、生の圧縮比よりも重要です。プローブベースの評価は、圧縮後に特定の保持された事実をテストし、実際のエージェントの使いやすさを評価するためにROUGE/埋め込み類似性を上回ります。分析は、Factoryの方がOpenAIの方法よりも生の圧縮は低いにもかかわらず、より高い精度とコンテキスト認識を報告しています。