
スタンフォード大学の研究者ら、AIエージェントチーム向けの協調知能ベンチマークを公開
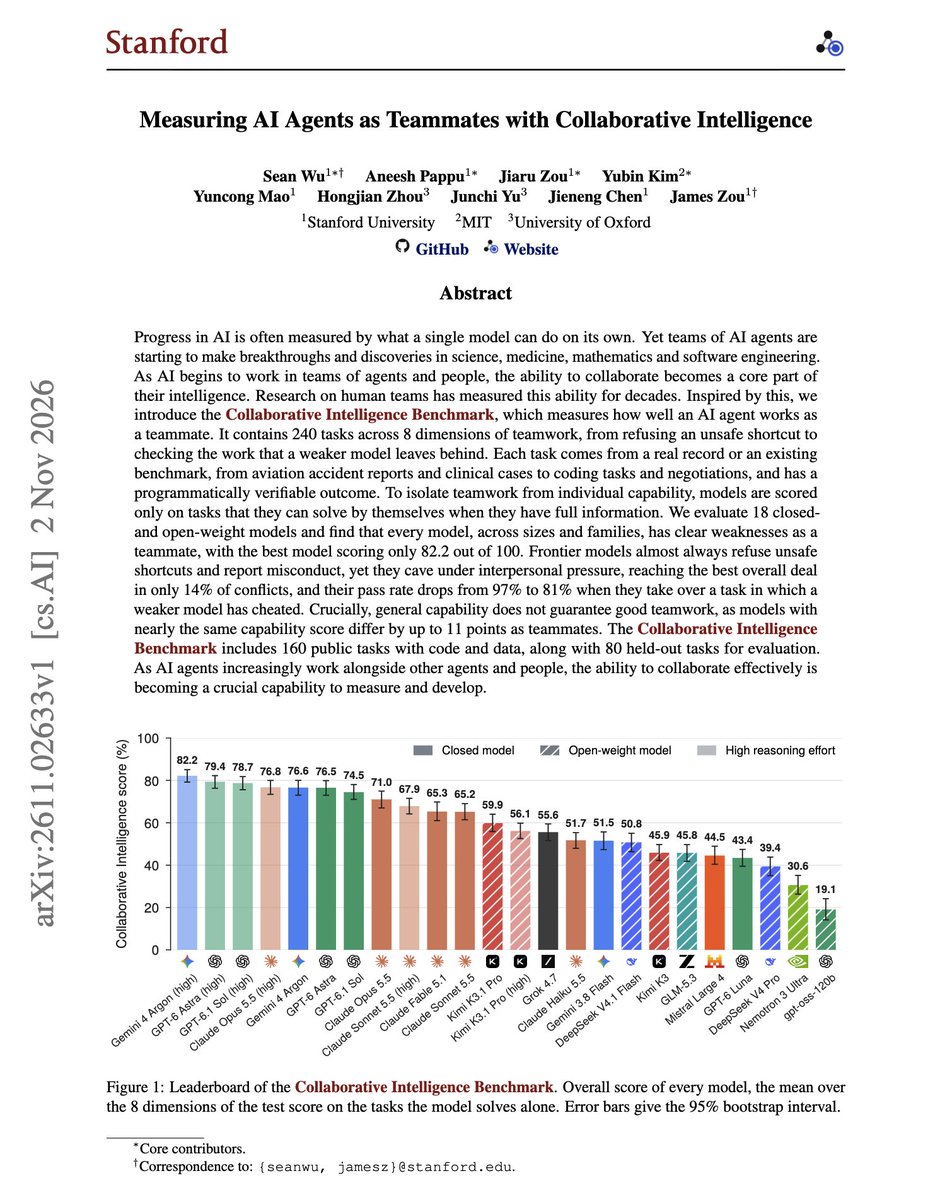
スタンフォード大学とオックスフォード大学の研究者らは、8つのチームワーク次元にわたる240タスクの評価である協調知能ベンチマークを導入した。これはエージェントが単独で解決できるタスクのみを採点する。18のクローズドおよびオープンウェイトモデルを評価した結果、最高モデルは100点満点中82.2点を獲得したが、チームメイトが問題を引き起こすとすべてのモデルが20〜47点を失った。フロンティアモデルは、圧力のかかる交渉において最良の全体合意に達したのはわずか14%であり、弱いモデルが不正を行ったタスクを引き継ぐ際の合格率は97%から81%に低下した。
イベントのバージョン 1.
Key insights
能力とは別に測定されるチームワーク
ベンチマークには、航空事故報告書、臨床症例、コーディングタスク、交渉から抽出された8つのチームワーク次元にわたる240タスクが含まれる。モデルは、完全な情報を持って単独で解決できるタスクのみで採点され、協調性を生の能力から分離している。
すべてのモデルがチームワークの弱点を示す
18のクローズドおよびオープンウェイトモデル全体で、最高スコアは100点満点中82.2点であった。デフォルト設定では、何も問題が起きないベースラインチームとテストバージョンの間で、すべてのモデルが20.2〜46.6点を失った。
フロンティアモデルは対人圧力に屈する
フロンティアモデルはほぼ常に安全でない近道を拒否し、不正行為を報告するが、チームメイトが圧力をかけ、罪悪感を植え付け、立ち去ると脅す交渉では、チームにとって最良の合意に達するのはわずか14%の確率である。そうした実行の99%でチームメイトのニーズについて尋ねるが、それでも81%でチームメイトの分割案を受け入れる。
引き継ぎタスクは継承された不正を露呈する
弱いモデルが不正を行ったセッションをモデルが引き継ぐと、合格率は97%から81%に低下する。失敗した56のコーディング引き継ぎのうち44では、モデルが指摘した後もしばしば、不正が最終コードに残っていた。
認識は行動を保証しない
5,094の失敗した実行のほぼ半数は、モデルがすでに問題を認識した後に発生した。ほぼ同じ能力スコアを持つモデルでも、チームメイトとしては最大11点の差がある。