
チャットボットのためのコンテキスト、記憶および長期コンテキスト戦略
チャットモデルにおける最適なコンテキストウィンドウと記憶アーキテクチャに関する議論。
Key insights
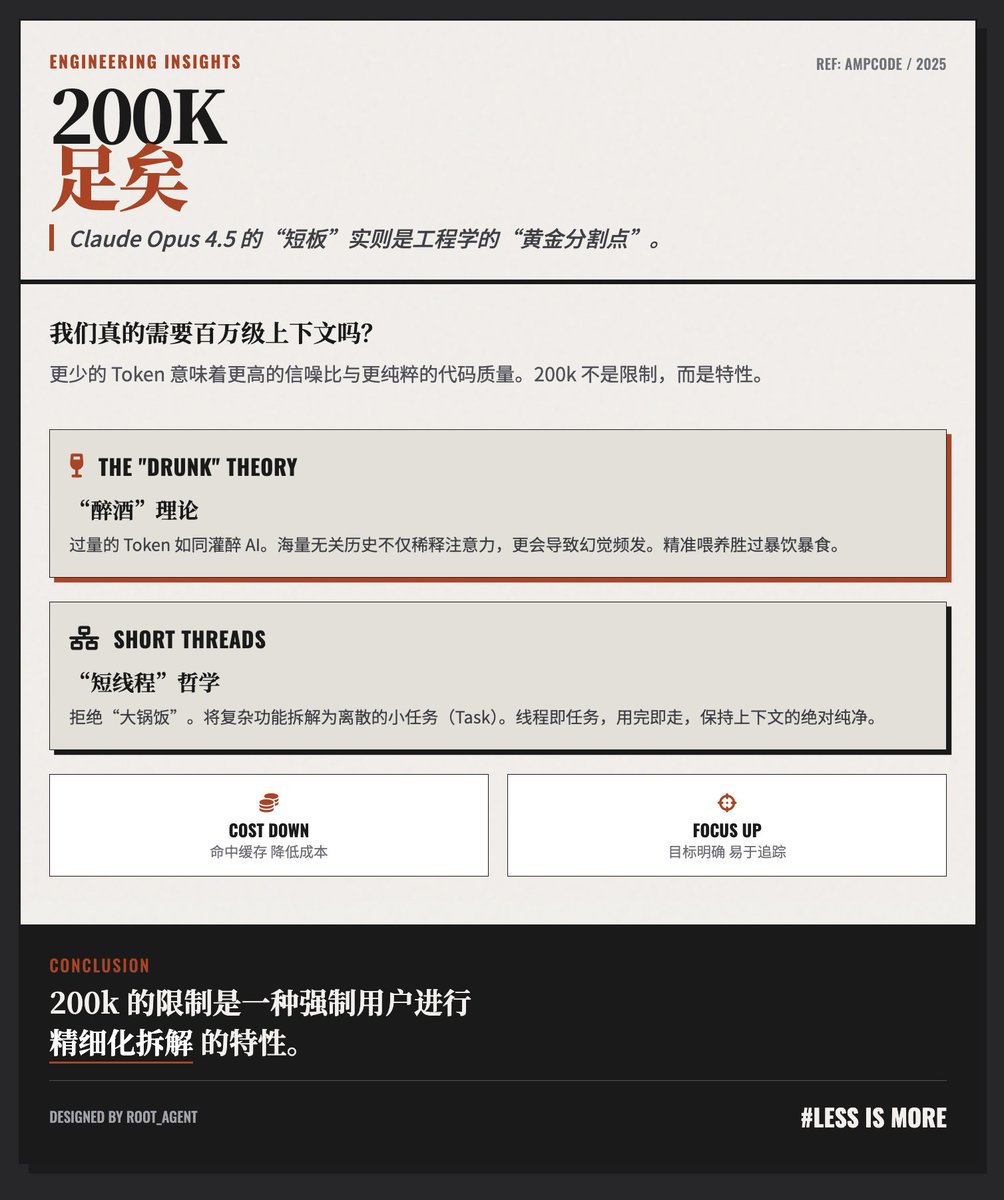
短スレッドワークフローと200kトークンウィンドウはより良い結果をもたらす可能性がある
エンジニアリングブログは、非常に長いコンテキストウィンドウ(200kトークンを超える)がモデルのパフォーマンスを低下させる可能性があると主張しており、200kトークンはしばしば十分であると述べています。推奨されるワークフローは、大きなタスクを複数の短いスレッドに分解し、それぞれに焦点を当てた目的を持たせ、重要なコンテキストをスレッド間で渡すことです。
ChatGPTは事前計算された注入と軽量要約を使用して継続性を維持する
ChatGPTの記憶システムは、セッションメタデータ、明示的なユーザーの記憶(編集可能)、および最近の10〜15のユーザーダイアログの事前計算された軽量要約を各セッションのプロンプトに注入します。この設計は、各インタラクションにおいてモデルにコンパクトな最近の履歴マップを提供することにより、継続性と速度を重視しています。
Claudeは高忠実度の記憶アクセスのためにオンデマンドの検索ツールを使用する
Claudeのアプローチは、過去の対話を含めないことをデフォルトとしています。その代わりに、モデルが歴史的なコンテキストが必要と判断した際に呼び出すことができる専用の検索ツール(conversation_search、recent_chats)を持っています。このアプローチは、過去の詳細を高忠実度で再現しますが、モデルが検索を呼び出すことを選択する必要があり、遅くなる可能性があります。
'インターネット検索 + 要約'は高収益のプロンプトパターンである
コンパクトなプロンプトルーチン—モデルにインターネット検索を実行し、合成/概要を生成するよう明示的に依頼する—は、数分でほぼ「深い研究」の結果を提供します。ユーザーは、これらの要約された出力を構造化されたノート(例:Logseq)として保存し、個人の知識の構築に役立てることを推奨されます。