
トレーニングと計算力の競争:TPUv7とトレーニングインフラのリスク
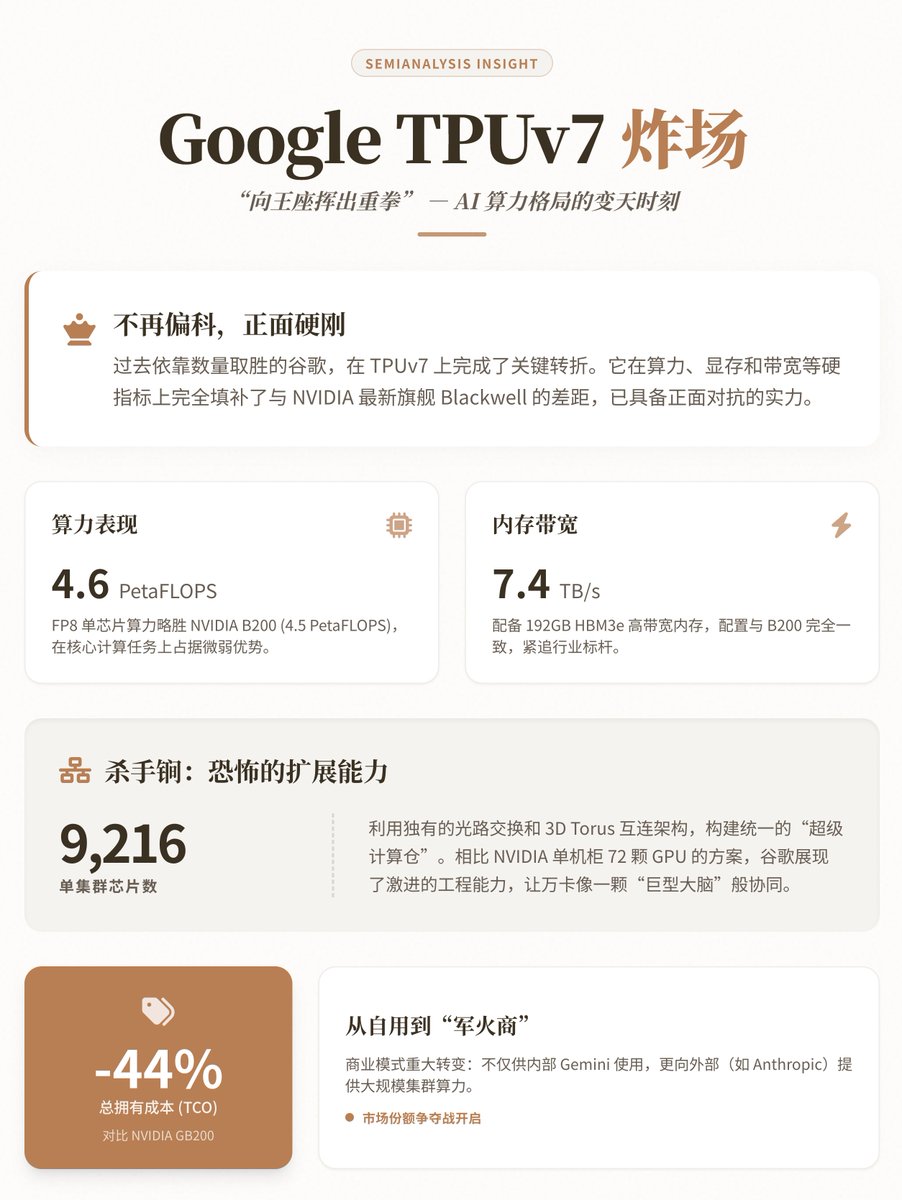
分析によると、TPUv7(Ironwood)は、単一チップの計算力、メモリ、および帯域幅においてNVIDIA Blackwellに接近または追いついており、大規模な相互接続と所有コストにおいて優位性を持つ。一方で、研究者はトレーニングインフラがリスクの中心であると警告している。
Key insights
TPUv7は単一チップおよびメモリ仕様でBlackwellに追いつくまたは超える
分析によると、TPUv7のFP8計算力は約4.6 PFLOPSであり、192GB HBM3eと約7.4 TB/sのメモリ帯域幅を備えている。単一チップの性能指標はNVIDIA Blackwell(B200)と同等であり、Googleがハードウェア設計において重要な突破口を実現したことを示している。
TPUv7の拡張相互接続とクラスター規模は差別化された優位性
Googleは光路交換と3Dトーラス相互接続アーキテクチャを通じて、数千から9,216個のTPUv7を統一された超大クラスターに接続することができる。この大規模で低遅延の相互接続は、超大モデルのトレーニング時に通信ボトルネックを大幅に削減できるため、相対的な競争優位性の鍵となる。
TPUv7は総所有コストにおいて顕著な競争力を持つ
分析によると、Googleの垂直統合されたTPUv7ソリューションは、NVIDIA GB200サーバーソリューションの導入に比べて総所有コストが約44%低いと推定されており、大規模なトレーニング計算力を必要とする機関にとって経済的な魅力を持つ。
トレーニングインフラは資本とリスクの集中地、アプリケーション層は相対的に過小評価されている
吴恩达はAIをアプリケーション、推論、トレーニングの三層に分けることを提案した。アプリケーション層は現在過小評価されており、長期的な価値が無視されている。推論層には供給の緊張が存在し、トレーニング層は資本集約的でリスクが最も大きい分野であり、オープンソースモデルとハードウェアの進展が単一のベンダーの競争優位性を弱める可能性がある。