ナノバナナプロ、ネイティブマルチモーダルトランスフォーマーを使用して正確な中国語テキストを生成
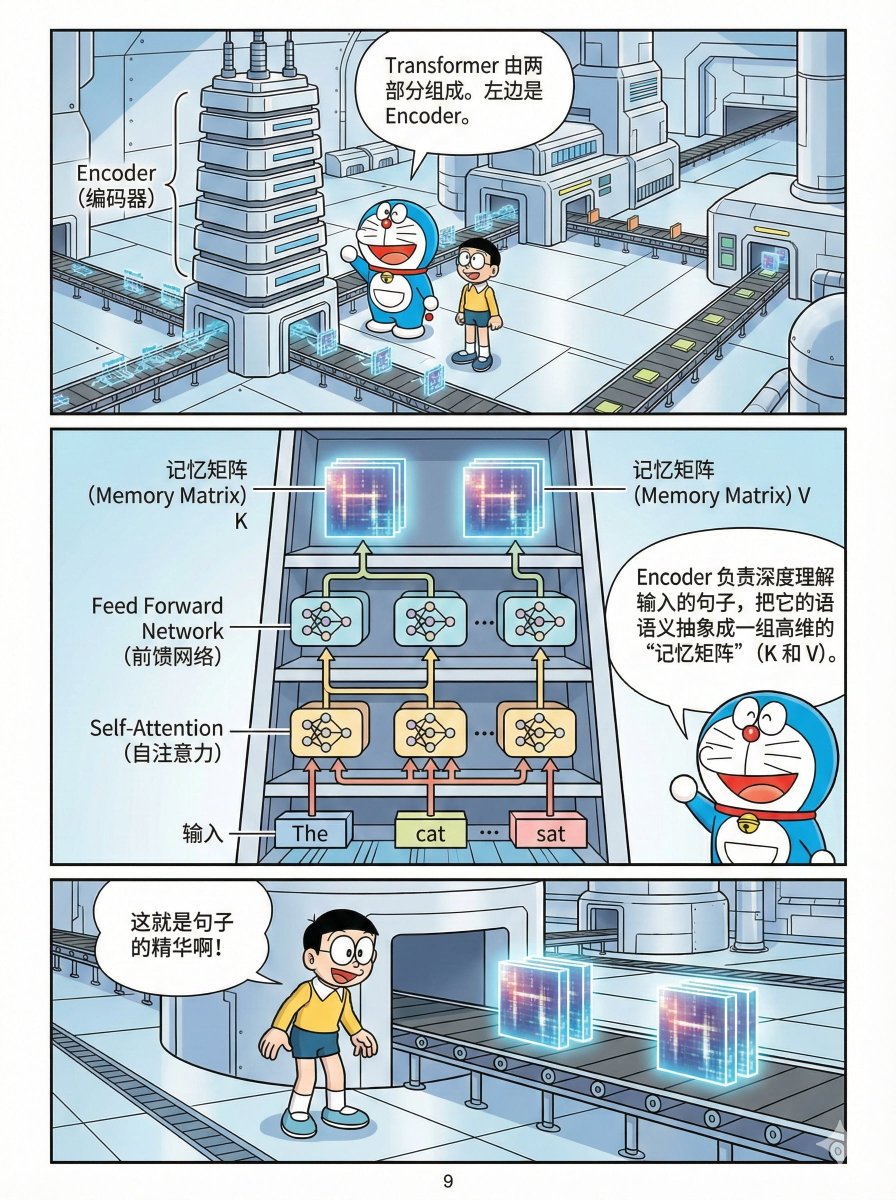
説明は、テキストの生成が不十分な拡散ピクセルベースの画像モデルと、ナノバナナプロやGPT-Image-1のようなネイティブなトークンイン/トークンアウトのマルチモーダルトランスフォーマーを対比しています。これらのモデルは、文字をモダリティを超えたトークンとして扱うことで、テキストの書き方ロジックを用いて画像内にテキストを生成し、複雑な中国語のPPTや漫画においてはるかに低い文字エラー率を実現します。

説明は、テキストの生成が不十分な拡散ピクセルベースの画像モデルと、ナノバナナプロやGPT-Image-1のようなネイティブなトークンイン/トークンアウトのマルチモーダルトランスフォーマーを対比しています。これらのモデルは、文字をモダリティを超えたトークンとして扱うことで、テキストの書き方ロジックを用いて画像内にテキストを生成し、複雑な中国語のPPTや漫画においてはるかに低い文字エラー率を実現します。