
ナノバナナプロとGPT-イメージモデルが画像内のテキストレンダリングを改善する理由
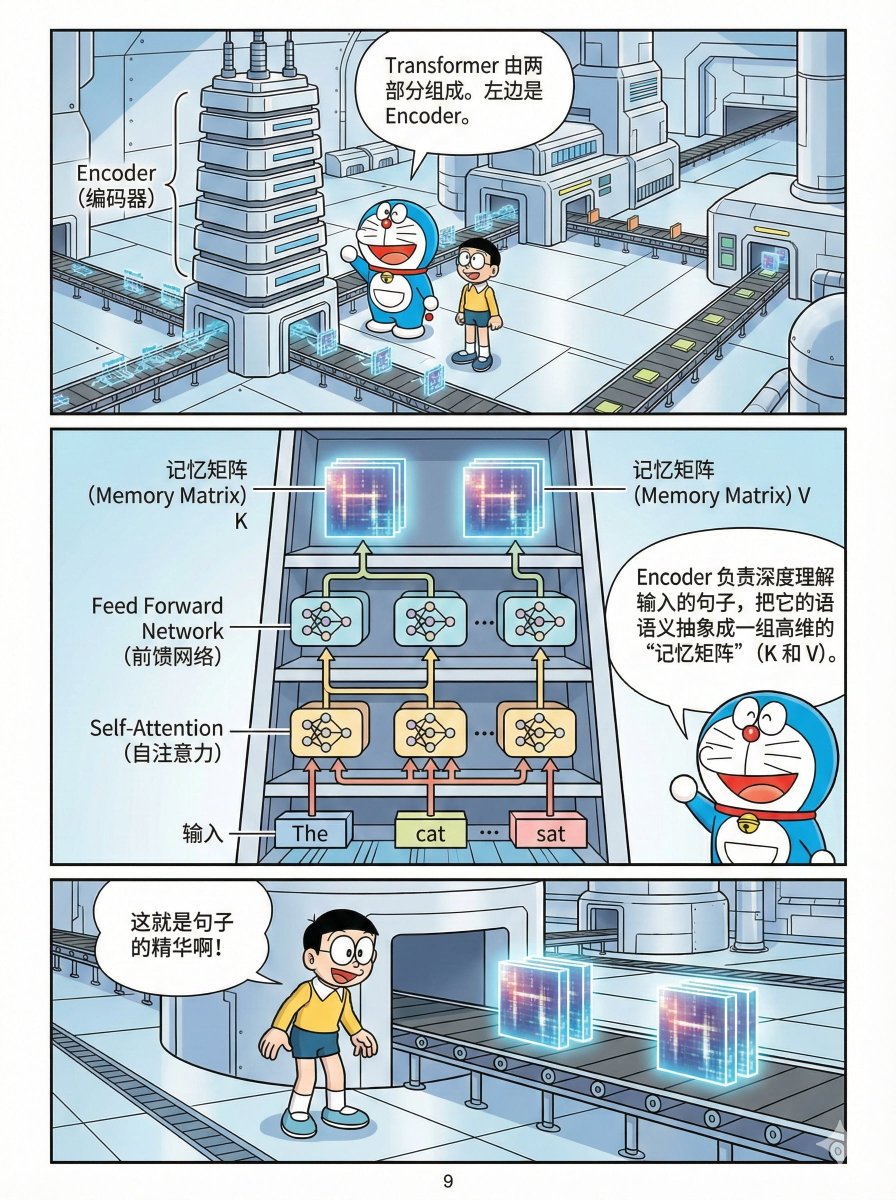
この記事では、拡散モデルが正確な文字レンダリングに苦労する理由と、ナノバナナプロやGPT-イメージ-1のようなネイティブマルチモーダルトランスフォーマー(トークンイン/トークンアウト)が画像内のテキストをはるかに良好に生成する理由を説明しています。トークン化されたクロスモーダル表現により、モデルは文字をピクセルを塗るのではなく、離散的なシンボルとして「書く」ことができるため、画像内の密なテキストに対するスペルエラー率が大幅に低下します。