
マルチリファレンスのアイデンティティ制御による画像編集
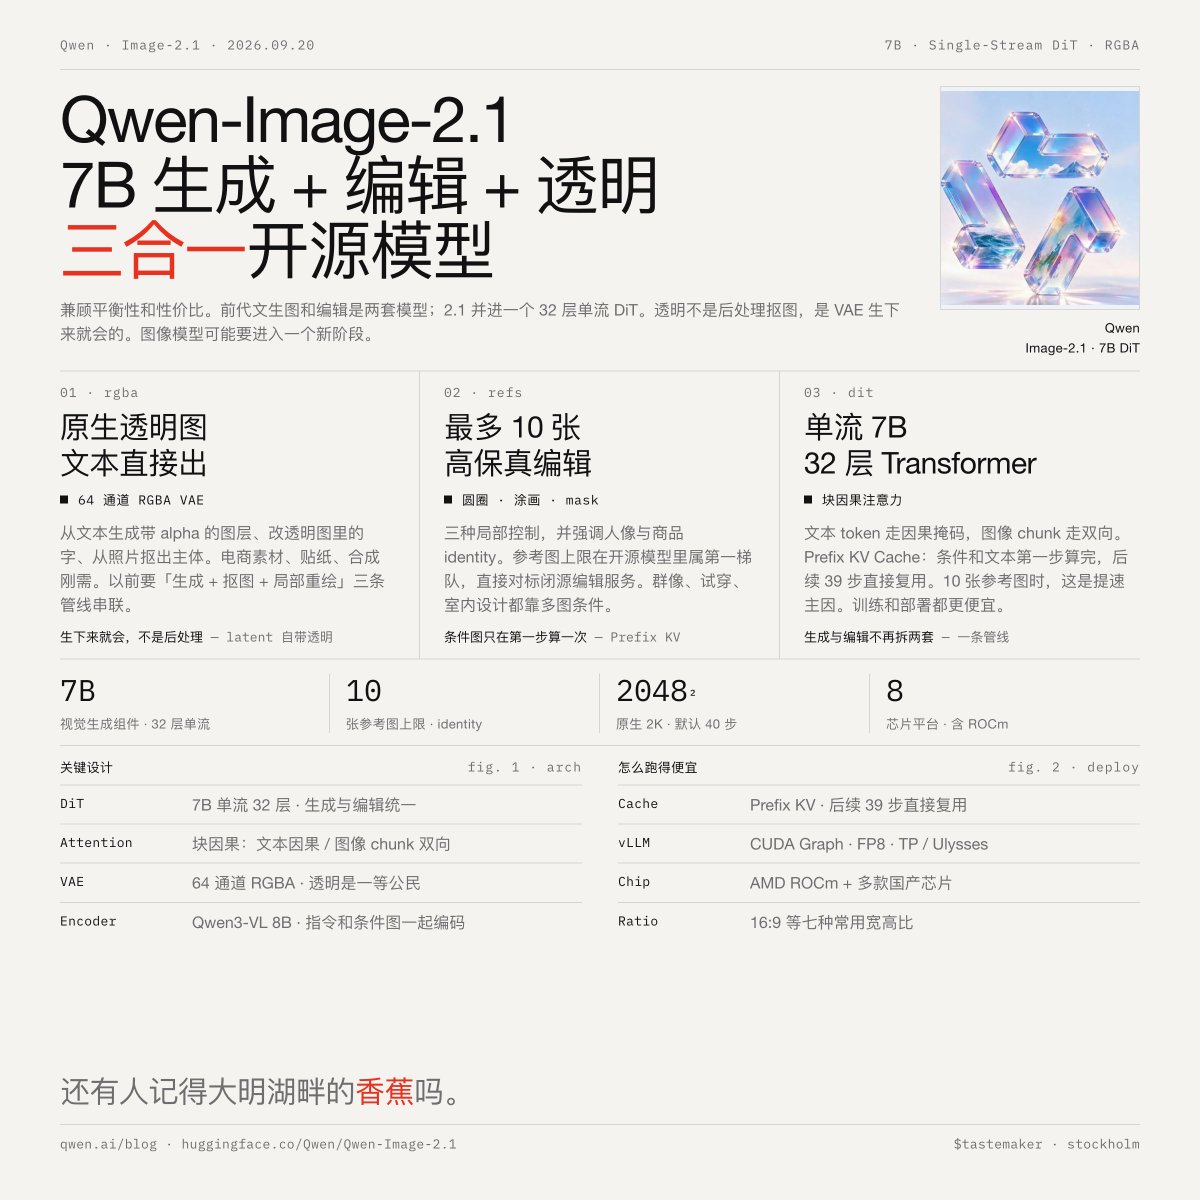
Qwen-Image-2.1は、画像生成、編集、およびネイティブの透明チャンネルサポートを組み合わせた70億パラメータのオープンソースモデルです。最大10枚の参照画像を処理して高忠実度のアイデンティティ保存編集を実現し、64チャンネルのRGBAオートエンコーダーでネイティブな透明性を提供します。また、CUDA Graph、FP8量子化、AMD ROCmを含むマルチチップサポートを備えたvLLMデプロイメントを提供します。
Key insights
ネイティブRGBA透明性生成
Qwen-Image-2.1は、アルファチャンネルを持つテキストから直接RGBAレイヤーを生成し、透明画像内のテキストを編集し、写真から被写体を抽出します。64チャンネルのオートエンコーダーは、後処理ではなく潜在空間でネイティブに透明性を保持し、これまで電子商取引用素材、ステッカーデザイン、合成ワークフローに必要だったマルチモデルパイプラインを置き換えます。
最大10枚の参照画像とアイデンティティ制御
このモデルは、最大10枚の参照画像による高忠実度編集をサポートしており、これはオープンソースモデルの中で最高水準です。3つのローカル制御方法として、円注釈、落書きマーキング、独立マスクがあります。ポートレートや製品のアイデンティティ保存は、GPT-Imageシリーズのようなクローズドソースの編集サービスと直接競合します。
シングルストリームDiTが生成と編集を統合
Qwen-Image-2.1は、これまで別々だったテキストから画像への生成モデルと編集モデルを、単一の32層トランスフォーマーに統合しました。ブロック因果注意は、テキストトークンに因果マスキングを、画像チャンクに双方向マスキングを適用します。この統一アーキテクチャにより、以前のデュアルモデルアプローチと比較してトレーニングおよびデプロイメントコストが削減されます。
プレフィックスKVキャッシュがマルチ画像編集を高速化
条件画像とテキストは最初のノイズ除去ステップでのみ一度計算され、その後の39ステップではキャッシュされた値を再利用します。これがマルチリファレンス編集シナリオにおける主な推論高速化です。デプロイメントオプションには、CUDA Graph、FP8量子化、TP/Ulysses並列処理、およびAMD ROCmを含む8つのチッププラットフォームのサポートが含まれます。
複数のアスペクト比に対応した2K解像度
このモデルは、ネイティブ2K解像度(2048x2048)で40のデフォルト推論ステップを実行し、16:9を含む7つの一般的なアスペクト比をサポートします。テキストレンダリングとポートレート照明は、Qwen-Imageシリーズから継承された定性的な強みであり、特に中国語テキストレンダリングに優れています。