メタ、AIによる粗悪な文章生成対策に「RL-XAR」を提案
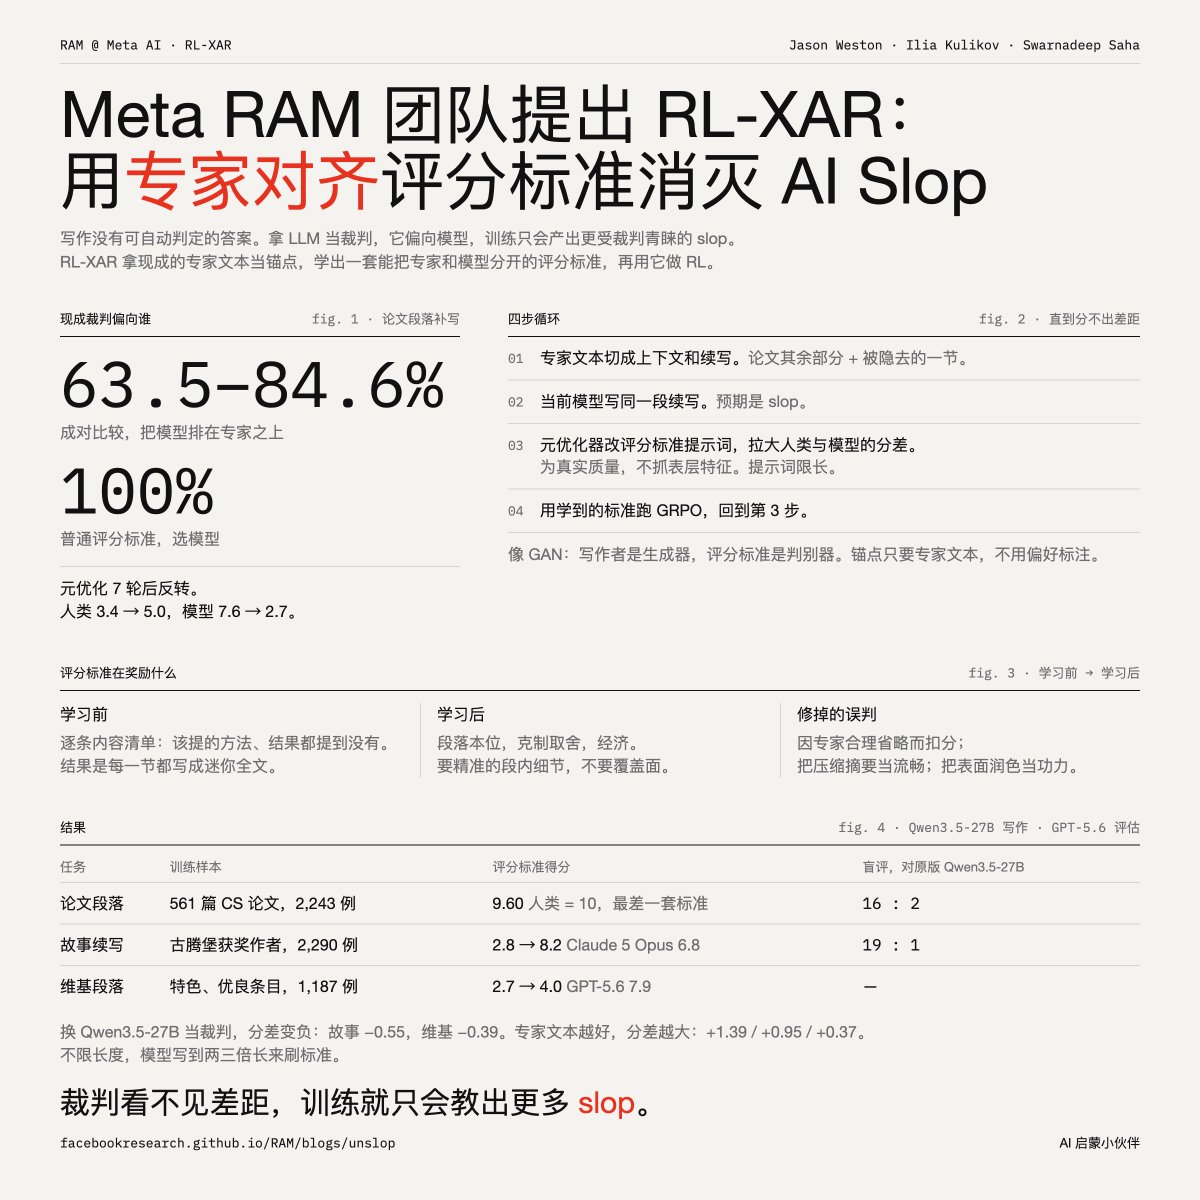
メタ社のRL-XAR手法は、専門家が作成した評価基準を強化学習の報酬信号として活用し、27Bモデルがブラインド評価で89〜95%の勝率を達成し、人間の専門家による執筆を上回る成果を示した。このアプローチは、検証が困難なタスク(例:文章作成)に対応するため、AIによる粗悪な出力(AIスロップ)と専門家によるテキストを区別する識別器を最適化する点に特徴がある。

メタ社のRL-XAR手法は、専門家が作成した評価基準を強化学習の報酬信号として活用し、27Bモデルがブラインド評価で89〜95%の勝率を達成し、人間の専門家による執筆を上回る成果を示した。このアプローチは、検証が困難なタスク(例:文章作成)に対応するため、AIによる粗悪な出力(AIスロップ)と専門家によるテキストを区別する識別器を最適化する点に特徴がある。