
メモリ、コンテキスト管理とエージェントスキル(Claude / ChatGPT)
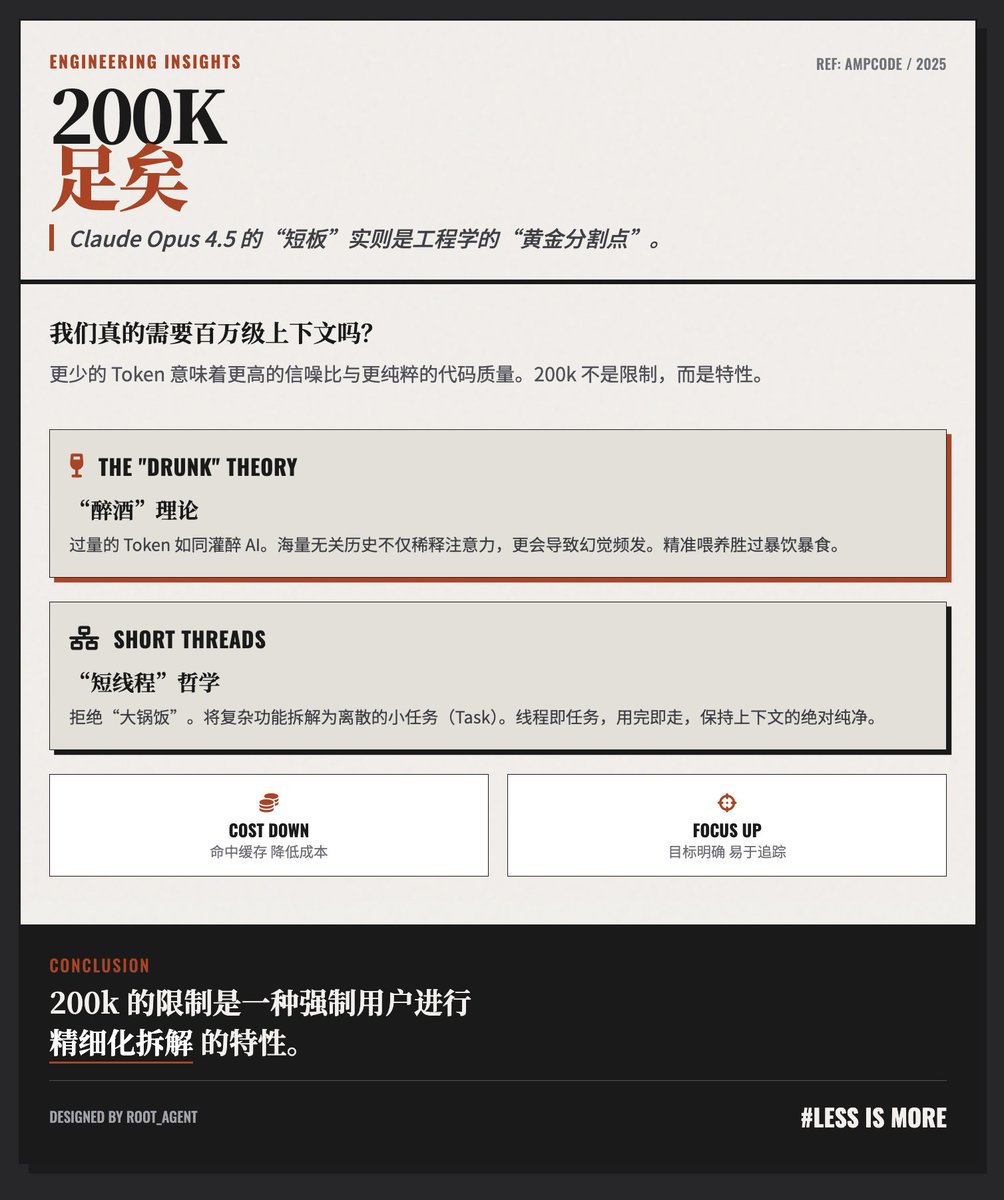
複数の分析が、現代の大規模言語モデル(LLM)のメモリアーキテクチャ、エージェントスキル、およびコンテキスト戦略を比較しています。 - あるエッセイでは、20万トークンが十分であると主張し、コンテキストノイズを避けるために「ショートスレッド」タスク分解を推奨しています(20万トークンは高品質なコーディングタスクに対して十分です)。 - ChatGPTのメモリ設計は、セッションメタデータ、ユーザーメモリ(長期的な事実)、最近の対話の要約(約10〜15セッション)、および現在のセッションウィンドウの4層で構成されています。 - Claudeのメモリ設計は、オンデマンドの検索ツール(conversation_search、recent_chats)を使用し、デフォルトで完全な履歴を注入しないことを特徴としています。 - Claude-Memオープンソースプロジェクトは、セマンティック圧縮とSQLiteを使用してClaude Codeのためのローカルで圧縮された永続メモリを提供し、トークンコストを削減し、セッション間の継続性を可能にします。 - ChatGPTは、Thinkingモデルに内蔵のエージェントスキルを導入し、最初の3つのスキル(excel、word、pdf)をサポートし、処理のためにローカルスキルファイルをzip化することを可能にします。 - 実用的なトレードオフが指摘されています:ChatGPTは注入によるシームレスなユーザー体験を重視し、Claudeは検索ツールによる精度を重視しています。
Key insights
20万トークンのコンテキストはコーディングワークフローに対して十分かつ好ましいと主張
ある技術的な投稿では、20万トークンのコンテキストウィンドウは高品質なコーディングやタスク実行に対する制限ではないと主張し、複雑なプロジェクトを複数の簡潔な「スレッド」に分割することを推奨しています。各スレッドには必要なコンテキストのみが含まれます。この主張は、巨大な連続履歴における信号対ノイズの懸念、トークンコスト、キャッシュの非効率性、および運用の管理可能性を引用し、短いスレッドワークフローが信頼性とコスト効率を向上させると主張しています。
ChatGPTは4層のメモリ注入アーキテクチャを使用
リバースエンジニアリングの作業では、ChatGPTのメモリを4層に分けて説明しています:セッションメタデータ(一時的な環境信号)、ユーザーメモリ(保存され注入される長期的な事実)、最近の対話の要約(約10〜15の前のセッションの軽量な要約)、および現在のセッションウィンドウ。この設計は、パーソナライズ、トークンコスト、および応答性のバランスを取るために、事前計算された要約と明示的な長期的事実を強調しています。
Claudeは正確な過去コンテキストアクセスのためにオンデマンドの検索ツールに依存
Claudeのメモリアプローチは、リトリーバルファーストの設計として説明されており、デフォルトで過去の対話を注入せず、モデルが歴史的なコンテキストが必要であると判断したときに呼び出すツール(conversation_search、recent_chats)を提供します。これにより、過去の詳細の高忠実度な取得が可能になりますが、レイテンシが追加され、モデルがツールを呼び出すタイミングを判断する必要があります。
オープンソースおよびサードパーティプロジェクトが永続的な圧縮メモリとスキルを追加
Claude-Memのようなプロジェクトは、セマンティック圧縮とSQLiteストレージを使用してClaude Codeのためのローカルで圧縮された永続メモリを提供し、セッション間のコンテキストを復元しながらトークン使用量を削減します。別途、ChatGPTのThinkingモデルはエージェントスキル(excel、word、pdf)を出荷し、圧縮されたローカルスキルファイルの読み込みをサポートしています。オープンソースのツールやエージェントスキルマネージャーが登場し、スキルロジックをモデルのコンテキストウィンドウの外にオフロードしています。